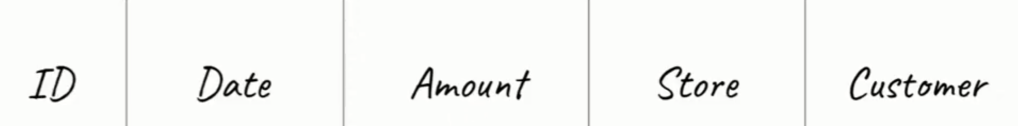
Tag: Data

  • 13 Methods from Brazilian E-Commerce Public Dataset by Olist Big Query

    13 Methods from Brazilian E-Commerce Public Dataset by Olist Big Query

    Introduction

    ในยุคที่ธุรกิจ e-Commerce ขับเคลื่อนด้วยข้อมูลอย่างเข้มข้น ในส่วนของพฤติกรรมการซื้อ-ขายบนแพลตฟอร์มต่างๆ ถือเป็นสินทรัพย์เชิงกลยุทธ์ที่มีมูลค่ามหาศาล ความเชี่ยวชาญของผมคือการเปลี่ยนข้อมูลดิบ (Raw Data) เหล่านั้นให้กลายเป็นกลยุทธ์ที่จับต้องได้ โดยการใช้ SQL และ BigQuery ในการจัดการและวิเคราะห์ข้อมูลขนาดใหญ่ (Big Data) พร้อมทั้งแปลงข้อมูลให้เห็นภาพ (Data Visualization) ผ่าน Google Sheets และ Looker Studio (Data Studio) เพื่อส่งมอบ Key Insights และ Business Recommendations ที่แม่นยำ ช่วยขับเคลื่อนการตัดสินใจและสร้างการเติบโตทางธุรกิจได้อย่างแท้จริง


    Dataset Reference

    https://www.kaggle.com/datasets/olistbr/brazilian-ecommerce


    Big Query -> Google Sheet

    ได้ข้อมูลจาก Data จาก Big Query มาเป็น Google sheet ได้จาก link นี้: https://docs.google.com/spreadsheets/d/11gIwtl0Mz9Lx3D-rnuGE5urOnSwgFU8CYqimfI7bzmc/edit?gid=1424175902#gid=1424175902


    Google Sheet -> Data Studio

    Data Studio จาก google sheet ที่เป็น Data Source ดังนี้

    https://datastudio.google.com/reporting/6c425f7f-1107-4fe7-865d-95995947d090


    Table of Content from Olist

    1. Introduction
    2. Project Overview & Objective
      1. Challenge
      2. Goal
    3. Tech Stack & Data Pipeline
      1. Google Cloud BigQuery (SQL)
      2. Looker Studio
    4. Data Source
      1. Element of table
        1. olist_orders_dataset
        2. olist_order_items_dataset
        3. olist_products_dataset
        4. olist_order_payments_dataset
        5. olist_order_reviews_dataset
        6. olist_customers_dataset
        7. olist_sellers_dataset
        8. olist_geolocation_dataset
        9. product_category_name_translation
    5. Big Query Process
      1. Create Dataset
      2. Create Table
    6. First Method : Create Dataset
    7. Second Method : Create Table
      1. Source
      2. Destination
      3. Schema
      4. Advanced options
    8. RFM Analysis
      1. Table 1 : With Reference_date AS
        1. Solve Problem
      2. Table 2 : product-frm-raw AS
        1. SELECT product_category_name
        2. Find Recency Date
        3. Find Frequency
        4. Find Monetary
        5. Join 3 Table
        6. Use Where and Group by
      3. Table 3 : product_scoring AS
        1. NTILE
        2. Product_scoring
      4. Table 4 : Product Segmentation
        1. product_rfm_code
        2. Condition of product_category_name
    9. Export form Big Query to Data Studio
      1. Cost Optimization
      2. Data Manipulation
      3. Access Control
    10. Data studio
      1. Drop Down
        1. Product_english_name
        2. Product_Segment
      2. Scorecard
      3. Top 10 Revenue
      4. Market Share of Top Categories
      5. Brazilian E-Commerce Public Dataset Query Table
      6. product_segment by Record Count
      7. Distribution of frequency by monetary
        1. Top-performing product group
        2. High Ticket product group
        3. Concentrated product group
    11. Key Insights from Dashboard
      1. Revenue Backbone
      2. Volume vs. Value Drivers
        1. Volume Driver
        2. Value Driver
        3. The Ultimate Star
        4. Inventory Red Flag
    12. Business Recommendations
      1. Cross-Category Bundling
      2. High-Value
      3. Subscription / Retention Model
    13. Conclusion

    Project Overview & Objective

    Challenge

    • โจทย์ของ Project นี้มีไว้เพื่อวิเคราะห์ภาพรวมและจัดกลุ่มประสิทธิภาพของหมวดหมู่สินค้าของธุรกิจ e-Commerce จาก Big-Query ในประเทศบราซิล (Olist Dataset) ว่าในข้อมูลเหล่านี้มีข้อมูลเชิงลึกอะไรที่น่าสนใจบ้าง

    Goal

    • เป้าหมายสำหรับ Project นี้มีการประยุกต์ใช้แนวความคิดของ RFM Analysis เพื่อเปลี่ยนมิติจากการมองพฤติกรรมของลูกค้า มาเป็นการประเมินว่ามี Quality หรือ Product Segment ที่ดีมั้ยในการขาย เพื่อช่วยให้ทีมบริหารจัดสรรทรัพยากร วางแผนการตลาด และจัดการสินค้าคงคลังได้อย่างแม่นยำ

    Tech Stack & Data Pipeline

    Google Cloud BigQuery (SQL)

    ใช้ในการเขียนคำสั่งวิเคราะห์ระดับสูง ใช้ CTE (WITH) ในการจัดระเบียบโครงสร้างโค้ด และใช้ Window Functions (NTILE()) ในการทำ Scoring แบ่งเกรดสินค้าออกเป็น 5 ระดับอย่างเที่ยงตรง รวมถึงมีการล้างข้อมูล (Data Cleaning) กรองออเดอร์ที่พังออกด้วย

    WHERE order_status NOT IN ('canceled', 'unavailable')
    

    Looker Studio

    ใช้ในการออกแบบและทำ Data Visualization เปลี่ยนผลลัพธ์จาก SQL (Big Query) เป็นลงในการ Google Sheet แล้วมาสร้างระบบ Dashboard ใน Data Studio ที่เป็น Interactive (สามารถกดฟิลเตอร์เลือกดูตามกลุ่มสินค้าได้ทันที)

    SQL (Big Query) -> Google Sheet -> Data Studio


    Data Source

    • เป็นข้อมูลของแบรนด์ Olist ซึ่งเป็น Platform E-Commerce ยักษ์ใหญ่ที่ช่วยเชื่อมต่อร้านค้าขนาดเล็กของบราซิลเข้ากับช่องทางการขายออนไลน์ต่างๆ โดยเป็นข้อมูลช่วงปี 2016 ถึง 2018 รวมแล้วประมาณ 100,000 คำสั่งซื้อ

    Element of table

    มีข้อมูลทั้งหมด 9 ตารางดังนี้

    olist_orders_dataset

    เป็นตารางหลัก ซึ่งเป็น primary key สำหรับข้อมูลชุดนี้

    เป็นตารางที่ไว้บอกการเก็บสถานะของคำสั่งซื้อ (เช่น delivered, shipped, canceled) และที่สำคัญที่สุดคือมี Timestamp ของทุก Process เช่น วันที่กดสั่งซื้อ, วันที่กดยืนยันชำระเงิน, วันที่ส่งของให้ขนส่ง, และวันที่ของถึงมือลูกค้า (เหมาะมากกับการทำ Time-to-Delivery Analysis)


    olist_order_items_dataset

    • รายละเอียดสินค้าในแต่ละบิล เช่น
    1. บิลนี้ซื้อสินค้าอะไรบ้าง (Product ID)
    2. ซื้อจากร้านไหน (Seller ID)
    3. ราคาเท่าไหร่ (Price)
    4. ค่าส่งเท่าไหร่ (Freight Value)

    olist_products_dataset

    • ข้อมูลของตัวสินค้า เช่น หมวดหมู่สินค้า (Category Name), ขนาด, น้ำหนัก และจำนวนรูปภาพที่ใช้โปรโมท (เอาไว้ทำวิเคราะห์ได้ว่า สินค้าที่รูปเยอะๆ หรือน้ำหนักเยอะ มีผลต่อยอดขายและค่าส่งอย่างไร)

    olist_order_payments_dataset

    • รูปแบบการชำระเงิน (เช่น บัตรเครดิต, บิลเงินสด, บัตรกำนัล) และจำนวนงวดที่ขอผ่อนชำระ (Installments)

    olist_order_reviews_dataset

    • คะแนนรีวิว (Review Score 1-5 ดาว) พร้อมข้อความรีวิวจากลูกค้า (ตารางนี้สายหัตถการหรือบริการแบบคุณสามารถนำมาฝึกทำ Sentiment Analysis หรือดูว่าลูกค้าติชมเรื่องอะไรได้ดีมาก)

    olist_customers_dataset

    • ข้อมูลฝั่งลูกค้า โดยจะมี ID ของลูกค้า และรหัสไปรษณีย์ (Zip Code) เมือง และรัฐที่ลูกค้าอาศัยอยู่

    olist_sellers_dataset

    • ข้อมูลฝั่งร้านค้าที่มาลงขาย มีรหัสไปรษณีย์ เมือง และรัฐ ของร้านค้าเช่นกัน

    olist_geolocation_dataset

    • พิกัดละติจูด (Latitude) และลองจิจูด (Longitude) ของรหัสไปรษณีย์ต่างๆ ในบราซิล (อันนี้ไฮไลท์เลยครับ! เพราะคุณสามารถดึงไปพลอตแผนที่ Heatmap สวยๆ บน Looker Studio โชว์สกิลการทำ Geospatial Analysis ได้เลย)

    product_category_name_translation

    • ตารางพจนานุกรม เนื่องจากข้อมูลหมวดหมู่สินค้าในตารางหลักเป็นภาษาโปรตุเกส ตารางนี้จะช่วยแปลเป็นภาษาอังกฤษให้เราอ่านง่ายขึ้นครับ

    Big Query Process

    Create Dataset

    การสร้าง Dataset คือหน่วยที่ใช้ในการจัดกลุ่มตารางข้อมูล (Tables) หรือมุมมองข้อมูล (Views) ที่มีความเกี่ยวข้องกันให้อยู่ในที่เดียวกัน เปรียบเสมือนการสร้าง “โฟลเดอร์หลัก” เพื่อรองรับไฟล์งานทั้งหมดของโปรเจกต์นี้


    Create Table

    การสร้าง Table คือการนำไฟล์ข้อมูลดิบ (เช่น .csv) ที่เตรียมไว้ ขึ้นไปสร้างเป็นตารางข้อมูลในระบบ โดยโครงสร้างการตั้งค่าของ BigQuery


    First Method : Create Dataset

    • เริ่มจากการตั้งชื่อ DataSet ใน BigQuery ก่อนด้วยชื่อ Brazilian_ECommerce
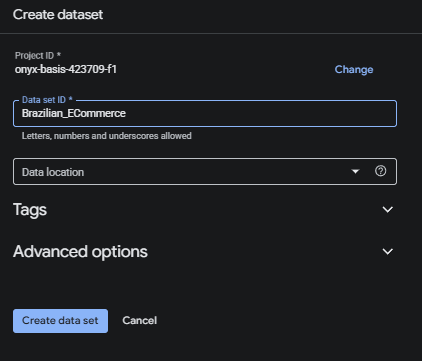
    หลังจากนั้นพิมพ์ชื่อลงไปแล้วกด Create Data Set ก็จะสามารถได้ Dataset ใหม่ใน Big Query


    Second Method : Create Table

    วิธีสร้าง Table ใน big query มีอยู่ 4 part ด้วยกัน

    1. Source
    2. Destination
    3. Schema
    4. Advanced Option

    Source

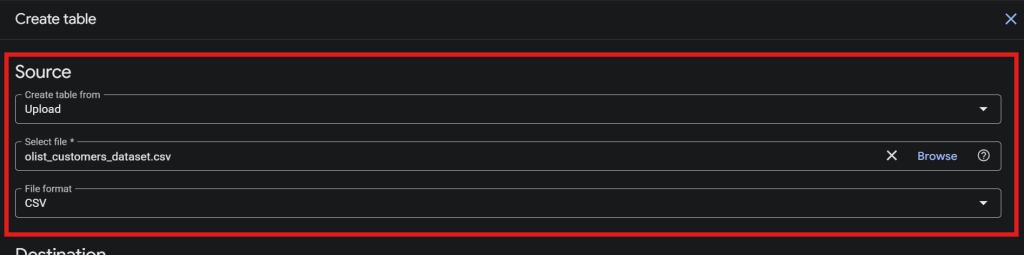
    1. ช่วงของ Source เลือกกด Upload จริงๆ สามารถเลือกได้หลากหลาย Data Source
    2. หลังจากนั้น Select file “olist_customers_dataset”
    3. หลัง File Format จะปรับเป็น CSV เอง

    Destination
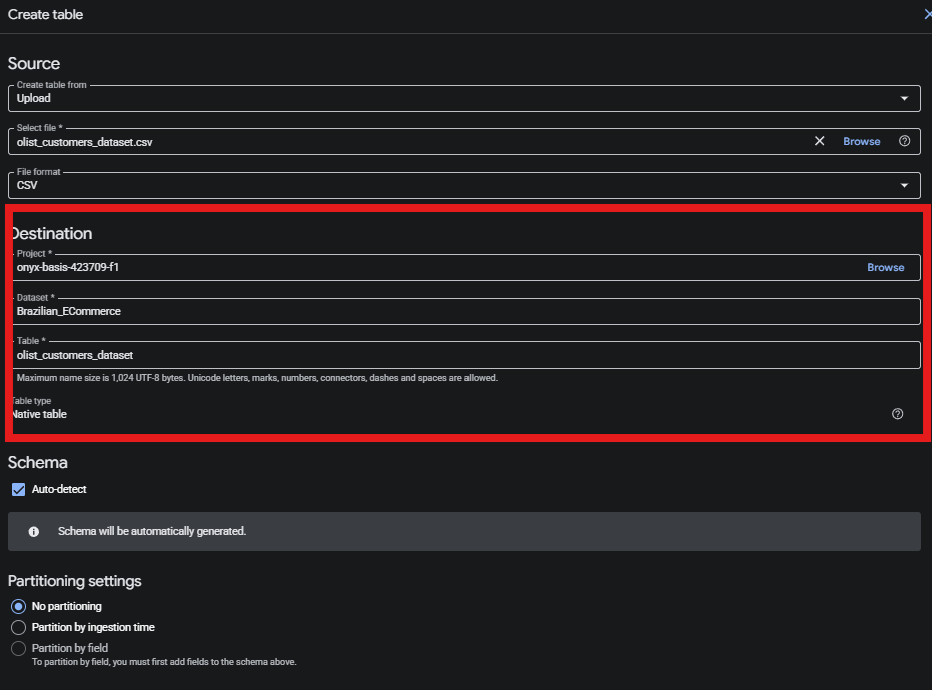
    1. Project ให้ชื่อที่เราสร้างขึ้น onyx-basis-423709-f1
    2. Dataset ให้เลือกสิ่งที่เราได้สร้างไว้ด้านบน Brazilian_ECommerce
    3. Table สามารถใช้ชื่อที่เราอยากตั้งได้เลย olist_customers_dataset

    Schema
    • สำหรับ Schema ให้เลือก Auto-detect

    Advanced options

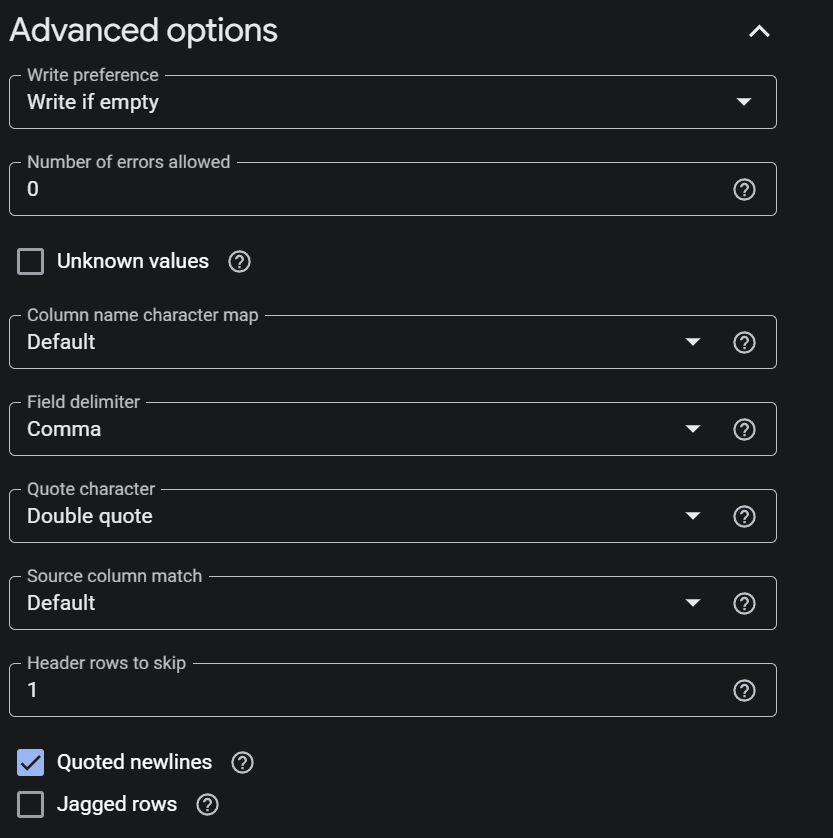
    • เลือก Header rows to skip คือ 1 ให้เลือกข้าม Column 1
    • ให้เลือก Quoted newlines
    • แล้วก็สร้างแบบนี้ทั้ง 9 ตาราง จากข้อมูลตารางด้านบน

    RFM Analysis

    • RFM Analysis (Recency, Frequency, Monetary) เป็นเครื่องมือทางการตลาดที่นิยมใช้ในการวิเคราะห์พฤติกรรมและความจงรักภักดีของ Product Health Analytics) แยกตามหมวดหมู่สินค้าทั้ง 74 หมวดหมู่ แทนการมองรายบุคคล เพื่อค้นหาว่าสินค้ากลุ่มไหนคือ Top Tier ของ product_category_name
    -- 1.Find Max Date with WITH Function
    WITH reference_date AS (
      SELECT MAX(order_purchase_timestamp) AS max_date
      FROM `onyx-basis-423709-f1.Brazilian_ECommerce.olist_orders_dataset`
    ),
    
    -- 2.Find RFM Analysis
    product_rfm_raw AS (
      SELECT
        COALESCE(p.product_category_name, 'unknown') AS product_category_name,
        
        -- Recency (R):
        DATE_DIFF(DATE((SELECT max_date FROM reference_date)), DATE(MAX(o.order_purchase_timestamp)), DAY) AS recency,
        
        -- Frequency (F):
        COUNT(DISTINCT o.order_id) AS frequency,
        
        -- Monetary (M):
        SUM(oi.price) AS monetary
        
      FROM `onyx-basis-423709-f1.Brazilian_ECommerce.olist_orders_dataset` o
      -- JOIN Table Items
      JOIN `onyx-basis-423709-f1.Brazilian_ECommerce.olist_order_items_dataset` oi 
        ON o.order_id = oi.order_id
      -- JOIN Table Products 
      JOIN `onyx-basis-423709-f1.Brazilian_ECommerce.olist_products_dataset` p 
        ON oi.product_id = p.product_id
        
      WHERE o.order_status NOT IN ('canceled', 'unavailable')
      GROUP BY p.product_category_name
    ),
    
    -- 3. Change 1-5 (Scoring) divide segment
    product_scoring AS (
      SELECT
        product_category_name,
        recency,
        frequency,
        monetary,
        -- R_Score: หมวดที่เพิ่งขายได้เร็วๆ นี้ (ค่าน้อย) ได้คะแนนสูง
        NTILE(5) OVER (ORDER BY recency DESC) AS r_score,
        -- F_Score: หมวดที่ขายได้จำนวนครั้งเยอะ ได้คะแนนสูง
        NTILE(5) OVER (ORDER BY frequency ASC) AS f_score,
        -- M_Score: หมวดที่ทำเงินรวมให้บริษัทสูงที่สุด ได้คะแนนสูง
        NTILE(5) OVER (ORDER BY monetary ASC) AS m_score
      FROM product_rfm_raw
    )
    
    -- 4. Divide (Product Segmentation) from score
    SELECT
      product_category_name,
      recency,
      frequency,
      monetary,
      r_score,
      f_score,
      m_score,
      CONCAT(CAST(r_score AS STRING), CAST(f_score AS STRING), CAST(m_score AS STRING)) AS product_rfm_code,
      
    -- Condition of segment
      CASE
        WHEN r_score >= 4 AND f_score >= 4 AND m_score >= 4 THEN 'Star Products'
        WHEN r_score >= 3 AND f_score >= 3 AND m_score >= 3 THEN 'Steady Sellers'
        WHEN r_score >= 4 AND f_score <= 2 AND m_score >= 3 THEN 'Trending / New Stars'
        WHEN r_score <= 2 AND f_score >= 3 AND m_score >= 3 THEN 'Fading Giants'
        WHEN r_score <= 2 AND f_score <= 2 AND m_score <= 2 THEN 'Dead Stock / Slow Moving'
        ELSE 'General Products'
      END AS product_segment
    FROM product_scoring
    ORDER BY monetary DESC;
    

    Table 1 : With Reference_date AS

    -- 1.Find Max Date with WITH Function
    WITH reference_date AS (
      SELECT MAX(order_purchase_timestamp) AS max_date
      FROM `onyx-basis-423709-f1.Brazilian_ECommerce.olist_orders_dataset`
    ),
    
    • คือประกาศสร้างตารางขึ้นมาชั่วคราว เลือกค่าวันที่มาเยอะที่สุด
    • ตั้งชื่อ max_date เพื่อดูว่า order สุดที่เกิดขึ้นมาคือ order เกิดขึ้นวันไหน
    • ให้ไปดึงข้อมูลมาจากตารางประวัติการสั่งซื้อ FROM onyx-basis-423709-f1.Brazilian_ECommerce.olist_orders_dataset

    Solve Problem

    • การแก้ปัญหาข้อจำกัดของ Aggregate Function ใน SQL

    ขั้นตอนสำหรับการหา (product_rfm_raw) จำเป็นต้องหาค่าวันซื้อล่าสุดของสินค้าแต่ละหมวดหมู่ด้วยคำสั่ง MAX(o.order_purchase_timestamp)

    ในทางไวยากรณ์ของภาษา SQL จึงไม่สามารถเอา Aggregate Function สองตัวมาคำนวณซ้อนกันตรงๆ ในบรรทัดเดียวได้ (เช่น เขียน DATE_DIFF(MAX(...), MAX(...)) ลบกันตรงๆ ระบบจะแสดง Error ออกมาทันที)

    การแยกคำสั่ง MAX() ตัวแรกสุดของทั้งระบบไปไว้ใน WITH reference_date จึงเป็นการแปลงค่าวันสุดท้ายของร้านให้กลายเป็น “ค่าคงที่ (Constant Value)” ล่วงหน้า ทำให้เราสามารถดึงคำสั่ง (SELECT max_date FROM reference_date) มาลบกับค่า MAX รายสินค้าในขั้นตอนถัดไปได้อย่างราบรื่นครับ


    Table 2 : product-frm-raw AS

    product_rfm_raw AS (
      SELECT
        COALESCE(p.product_category_name, 'unknown') AS product_category_name,
        
        -- Recency (R):
        DATE_DIFF(DATE((SELECT max_date FROM reference_date)), DATE(MAX(o.order_purchase_timestamp)), DAY) AS recency,
        
        -- Frequency (F):
        COUNT(DISTINCT o.order_id) AS frequency,
        
        -- Monetary (M):
        SUM(oi.price) AS monetary
        
      FROM `onyx-basis-423709-f1.Brazilian_ECommerce.olist_orders_dataset` o
      -- JOIN Table Items
      JOIN `onyx-basis-423709-f1.Brazilian_ECommerce.olist_order_items_dataset` oi 
        ON o.order_id = oi.order_id
      -- JOIN Table Products 
      JOIN `onyx-basis-423709-f1.Brazilian_ECommerce.olist_products_dataset` p 
        ON oi.product_id = p.product_id
        
      WHERE o.order_status NOT IN ('canceled', 'unavailable')
      GROUP BY p.product_category_name
    ),
    
    • เป็นตารางสร้างที่เพื่อคำนวณค่าตัวเลข Recency, Frequency, Monetary ของ model RFM Analysis

    SELECT product_category_name

    COALESCE(p.product_category_name, 'unknown') AS product_category_name,
    

    บรรทัด SQL ด้านบนดึงชื่อ product_category_name ถ้าสินค้าชิ้นไหนไม่มีชื่อหมวดหมู่ จะแสดงค่า NULLให้เปลี่ยนคำแสดงเป็น ‘unknown‘ แทนเพื่อไม่ให้ข้อมูลหลุดหาย


    Find Recency Date

    • เป็นการเลือกหมวดนี้ขายได้ครั้งล่าสุดกี่วันมาแล้ว
    DATE_DIFF(DATE((SELECT max_date FROM reference_date)), DATE(MAX(o.order_purchase_timestamp)), DAY) AS recency,
    
    • นำ วันที่อ้างอิงล่าสุด (SELECT max_date FROM reference_date) ที่เราตั้งไว้ใน Table ที่ 1 ซึ่งคือ คำสั่งซื้อครั้งล่าสุด – MAX(order_purchase_timestamp) วันที่สุดท้ายที่ซื้อจากที่จากตาราง olist_orders_dataset เพื่อหาว่าวันซื้อล่าสุดห่างจากวันที่ซื้อครั้งแรกเท่าไร
    • ใช้ DATE_DIFF เพื่อให้ผลลัพธ์ออกมาเป็น จำนวนวัน
    • สามารถนำวันเหล่าไปหาอ้างอิงได้ว่าลูกค้าที่ขาดกับเรานานมีอะไรบ้างแล้วไปตามลูกค้าเหล่านั้น

    Find Frequency

    COUNT(DISTINCT o.order_id) AS frequency,
    
    • นับเพื่อตัด order_id ที่ซ้ำให้เหลือ ให้เหลือเฉพาะค่าที่ไม่ซ้ำกัน (Unique Values ของ order_id) เพียงค่าเดียว จาก table olist_orders_dataset

    Find Monetary

    SUM(oi.price) AS monetary
    
    • ราคารวมสินค้าต่อชิ้นในออร์เดอร์นั้นๆ จาก table olist_order_items_dataset

    Join 3 Table

    FROM `onyx-basis-423709-f1.Brazilian_ECommerce.olist_orders_dataset` o
      JOIN `onyx-basis-423709-f1.Brazilian_ECommerce.olist_order_items_dataset` oi 
        ON o.order_id = oi.order_id
      JOIN `onyx-basis-423709-f1.Brazilian_ECommerce.olist_products_dataset` p 
        ON oi.product_id = p.product_id
    
    • เป็นการ join ทั้ง 3 ตารางเข้าด้วยกัน
    • JOIN ตาราง orders เข้ากับ ตาราง Items เพื่อดูว่าออเดอร์นั้นซื้อสินค้าชิ้นไหน ราคาเท่าไหร่
    • JOIN ตาราง Items เข้ากับ ตาราง Products เพื่อดึงชื่อหมวดหมู่สินค้า

    Use Where and Group by

    WHERE o.order_status NOT IN ('canceled', 'unavailable')
      GROUP BY p.product_category_name
    
    • ให้เลือก order_status ที่ไม่ได้มี Status canceled กับ unavailable ออกมา โดยจัดกลุ่มตาม product_category_name

    Table 3 : product_scoring AS

    -- 3. Change 1-5 (Scoring) divide segment
    product_scoring AS (
      SELECT
        product_category_name,
        recency,
        frequency,
        monetary,
        -- R_Score: categories with recent sales received high scores.
        NTILE(5) OVER (ORDER BY recency DESC) AS r_score,
        -- F_Score: categories with frequency sales receive high scores.
        NTILE(5) OVER (ORDER BY frequency ASC) AS f_score,
        -- M_Score: categories with high sales receive high scores.
        NTILE(5) OVER (ORDER BY monetary ASC) AS m_score
      FROM product_rfm_raw
    )
    

    NTILE

    NTILE(5) ใน SQL คือ Window Function ที่ใช้สำหรับ แบ่งข้อมูลออกเป็น 5 กลุ่มเท่าๆ กัน โดยจะเรียงลำดับข้อมูลจากมากไปน้อย (หรือน้อยไปมาก) ตามที่เรากำหนดก่อน แล้วค่อยแจกเลขกลุ่ม (1, 2, 3, 4, 5) ให้กับข้อมูลแต่ละแถว


    Product_scoring

    • คือการสร้างตารางขึ้นมาเพื่อตัดเกรดสินค้าออกเป็น 5 ระดับตาม 3 หัวข้อ ดังนี้
    Type of ScoringDefinition
    Recencyยิ่งเพิ่งขายได้เร็วๆนี้ Recency น้อย
    ยิ่งได้กลุ่มคะแนนสูง เกรด 5 การซื้อสินค้าล่าสุดเวลายิ่งน้อยยิ่งดี
    Frequencyยิ่งขายได้จำนวนครั้งเยอะ Frequency มาก
    ยิ่งได้กลุ่มคะแนนสูง เกรด 5
    Monetary ยิ่งยอดซื้อเยอะ Monetary มาก ยิ่งได้กลุ่มคะแนนสูง เกรด 5

    แล้วเลือก product_category_name, recency, frequency, monetary, r_score, f_score, m_score FROM product_rfm_raw จากตารางที่ 2 ที่เราตั้งขึ้น


    Table 4 : Product Segmentation

    -- 4. Divide (Product Segmentation) from score
    SELECT
      product_category_name,
      recency,
      frequency,
      monetary,
      r_score,
      f_score,
      m_score,
      CONCAT(CAST(r_score AS STRING), CAST(f_score AS STRING), CAST(m_score AS STRING)) AS product_rfm_code,
      
    -- Condition of segment
      CASE
        WHEN r_score >= 4 AND f_score >= 4 AND m_score >= 4 THEN 'Star Products'
        WHEN r_score >= 3 AND f_score >= 3 AND m_score >= 3 THEN 'Steady Sellers'
        WHEN r_score >= 4 AND f_score <= 2 AND m_score >= 3 THEN 'Trending / New Stars'
        WHEN r_score <= 2 AND f_score >= 3 AND m_score >= 3 THEN 'Fading Giants'
        WHEN r_score <= 2 AND f_score <= 2 AND m_score <= 2 THEN 'Dead Stock / Slow Moving'
        ELSE 'General Products'
      END AS product_segment
    FROM product_scoring
    ORDER BY monetary DESC;
    

    product_rfm_code

    • เป็นการสร้าง product_rfm_code เพื่อเอาคะแนนตัวเลข 3 ตัวมา “ต่อกันเป็นข้อความตัวเดียว” (เช่น คะแนน R=5, F=4, M=5 จะกลายเป็นรหัส “545”) เพื่อให้เราเห็นโปรไฟล์ของสินค้าหมวดนั้นๆ ได้ทันทีด้วยรหัส 3 หลัก
    CONCAT(CAST(r_score AS STRING), CAST(f_score AS STRING), CAST(m_score AS STRING)) AS product_rfm_code
    
    • เขียน CAST(… AS STRING) เพื่อสั่งให้ระบบเปลี่ยนสถานะของตัวเลขเหล่านั้น ให้กลายเป็น “ตัวอักษร/ข้อความ” ก่อน เพื่อให้ระบบมองเลข 5 เป็นแค่ตัวอักษรตัวหนึ่ง ไม่ใช่จำนวนนับ

    Condition of product_category_name

    -- Condition of segment
      CASE
        WHEN r_score >= 4 AND f_score >= 4 AND m_score >= 4 THEN 'Star Products'
        WHEN r_score >= 3 AND f_score >= 3 AND m_score >= 3 THEN 'Steady Sellers'
        WHEN r_score >= 4 AND f_score <= 2 AND m_score >= 3 THEN 'Trending / New Stars'
        WHEN r_score <= 2 AND f_score >= 3 AND m_score >= 3 THEN 'Fading Giants'
        WHEN r_score <= 2 AND f_score <= 2 AND m_score <= 2 THEN 'Dead Stock / Slow Moving'
        ELSE 'General Products'
      END AS product_segment
    FROM product_scoring
    ORDER BY monetary DESC;
    
    Condition of product_category_nameDefinition
    Star Productsr_score >= 4 AND f_score >= 4 AND m_score >= 4
    Steady Sellersr_score >= 3 AND f_score >= 3 AND m_score >= 3
    Trending / New Starsr_score >= 4 AND f_score <= 2 AND m_score >= 3
    Fading Giantsr_score <= 2 AND f_score >= 3 AND m_score >= 3
    Dead Stock / Slow Movingr_score <= 2 AND f_score <= 2 AND m_score <= 2
    General Productsคะแนนที่อยู่นอกเหนือเกณฑ์ด้านบน
    • แล้วตั้งชื่อเงื่อนไขเหล่านี้ทั้งหมดว่า product_segment
    • จากตาราง product_scoring แล้วเรียงข้อมูลจากมากไปน้อย จาก Column monetary ที่เป็นยอดขาย

    Export form Big Query to Data Studio

    แล้ว Export จาก Big query มา Google sheet แล้วเชื่อม data source ที่ data studio อีกทีเพราะ 3 เรื่องดังนี้

    1. เรื่องค่าใช้จ่าย (Cost Optimization) ****
    2. ความยืดหยุ่นในการแต่งข้อมูล (Data Manipulation)
    3. สิทธิ์ในการเข้าถึงข้อมูล (Access Control)

    ได้ข้อมูลจาก Data จาก Big Query มาเป็น Google sheet ได้จาก link นี้: https://docs.google.com/spreadsheets/d/11gIwtl0Mz9Lx3D-rnuGE5urOnSwgFU8CYqimfI7bzmc/edit?gid=1424175902#gid=1424175902


    Cost Optimization

    การประหยัดค่าใช้จ่ายในการ Query

    • เพื่อลดค่าใช้จ่ายในการ Scan ข้อมูลบน BigQuery โดยใช้ Google Sheets เป็นตัวพักข้อมูล (Data Caching) ทำให้ Looker Studio ไม่ต้องยิง Query ตรงไปที่คลังข้อมูลทุกครั้งที่มีการเปลี่ยนตัวกรอง

    Data Manipulation

    ความสะดวกและความยืดหยุ่นสำหรับ Data Analyst ในการปรับข้อมูล

    • ช่วยให้ Data Analyst สามารถปรับแต่งข้อมูล เพิ่มเติมคอลัมน์คำนวณ หรือทำ Data Cleaning เล็กๆ น้อยๆ ได้อย่างยืดหยุ่นและรวดเร็วกว่าการแก้โครงสร้าง Pipeline บน Cloud

    Access Control

    สิทธิ์ในการเข้าถึงข้อมูล

    • เป็นการจำกัดสิทธิ์การเข้าถึงฐานข้อมูลหลัก (BigQuery) เพื่อความปลอดภัย และแชร์เฉพาะข้อมูลสรุปที่จำเป็นผ่าน Google Sheets ให้กับผู้เกี่ยวข้องนำไปใช้งานต่อได้อย่างปลอดภัย

    Data studio

    Data Studio จาก google sheet ที่เป็น Data Source ดังนี้

    https://datastudio.google.com/reporting/6c425f7f-1107-4fe7-865d-95995947d090


    • มีการสร้าง Drop down จาก 2 Column เพื่อหา Insight ได้

    Product_english_name

    สร้างด้วย Column Product_english_name

    • กรองข้อมูลรายชื่อสินค้าในระดับสากล เพื่อดูประสิทธิภาพและยอดขายของสินค้าแต่ละรายการโดยตรง

    Product_Segment

    สร้างด้วย Column Product_Segment

    • กรองข้อมูลตามหมวดหมู่หรือกลุ่มสินค้า เพื่อวิเคราะห์ภาพรวมและแนวโน้มการเติบโตของแต่ละ Segment

    Scorecard

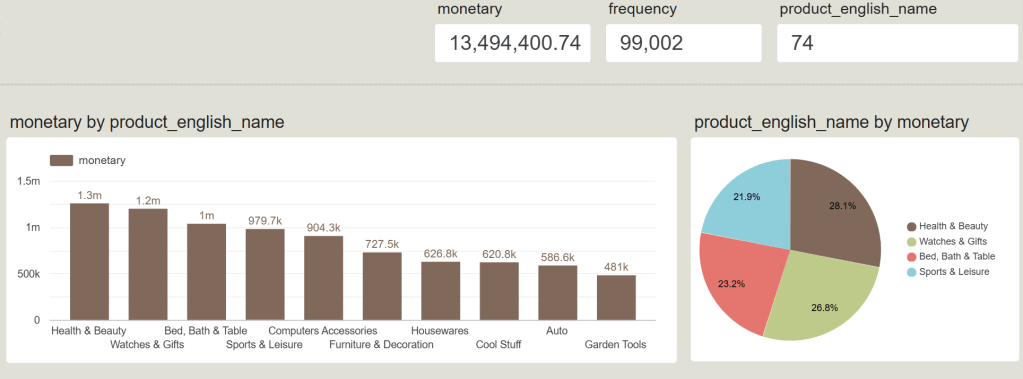
    เป็นส่วนที่บอกเรื่องภาพรวมทั้งหมดของ Product_english_name เพื่อให้เห็นขนาดของธุรกิจ (Scale):

    • monetary (13,494,400.74): ยอดขายสะสมรวมทั้งหมดของร้านค้า คิดเป็นเงินประมาณ 13.5 ล้าน
    • frequency (99,002): จำนวนครั้งที่มีการสั่งซื้อสำเร็จทั้งหมด 99,002 ออเดอร์
    • product_english_name (74): จำนวนประเภทหรือหมวดหมู่สินค้าทั้งหมดที่ร้านค้าชิ้นนี้มีวางจำหน่ายอยู่ 74 หมวดหมู่
    Top 10 Revenue

    กราฟ monetary by product_english_name ตัวนี้ทำหน้าที่จัดอันดับหมวดหมู่สินค้าที่ “ทำเงินสร้างรายได้สูงสุด 10 อันดับแรก” ให้แก่บริษัท (เรียงจากมากไปน้อย

    1. Health & Beauty (สุขภาพและความงาม): ครองแชมป์อันดับ 1 ทำเงินสูงสุดที่ 1.3 ล้าน
    2. Watches & Gifts (นาฬิกาและของขวัญ): ตามมาเป็นอันดับ 2 ทำเงินไป 1.2 ล้าน
    3. Bed, Bath & Table (เครื่องนอนและอุปกรณ์ในบ้าน): อันดับ 3 ทำเงินไป 1 ล้าน
    • ส่วนอันดับถัดๆ มา ได้แก่ Sports & Leisure (979.7k), Computers Accessories (904.3k), Furniture & Decoration (727.5k) ไล่ลงไปจนถึงอันดับ 10 คือ Garden Tools (481k)

    Market Share of Top Categories

    กราฟ product_english_name by monetary ตัวนี้เป็นการนำ Top 4 ของสินค้าที่ขายดีที่สุด มาสับไพ่เพื่อดูสัดส่วนการครองตลาด (Market Share) เฉพาะในกลุ่มสินค้าตัวท็อปด้วยกันเอง:

    CategoriesPercent
    Health & Beauty28.1 %
    Watches & Gifts26.8%
    Bed, Bath & Table23.2%
    Sports & Leisure21.9%
    • Health & Beauty มีสัดส่วนใหญ่ที่สุดคิดเป็น 28.1% ของกลุ่มสินค้าขายดี
    • Watches & Gifts ตามมาที่ 26.8%
    • Bed, Bath & Table อยู่ที่ 23.2%
    • Sports & Leisure อยู่ที่ 21.9%

    Brazilian E-Commerce Public Dataset Query Table

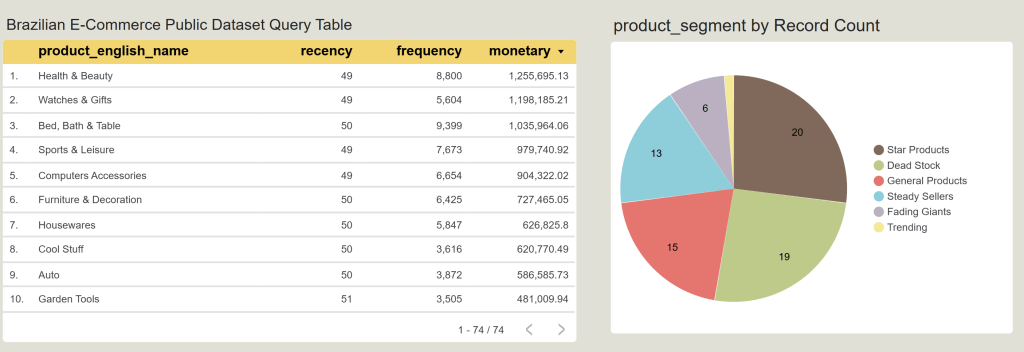
    ตารางนี้แสดงค่าตัวเลขดิบ (Raw Metrics) ของสินค้า 10 อันดับแรกที่ทำรายได้สูงสุด (เรียงตามคอลัมน์ monetary จากมากไปน้อย) โดยแต่ละมิติมองได้ดังนี้ครับ:

    • recency (ความสดใหม่): แสดงจำนวนวันที่หมวดหมู่นั้นๆ ไม่เกิดยอดขาย (นับถอยหลังข้ามไปหาอดีต) จะเห็นว่าสินค้า Top 10 ทั้งหมดมีค่า recency อยู่ที่ 49 – 51 วัน เท่าๆ กันหมด แปลว่าสินค้ากลุ่มนี้เป็นสินค้าที่ขายได้สม่ำเสมอ เพิ่งมีการสั่งซื้อไปไม่นานพร้อมๆ กัน
    • frequency (ความถี่ในการซื้อ): จำนวนออเดอร์ที่เกิดขึ้น น่าสนใจตรงที่อันดับ 3 อย่าง Bed, Bath & Table มีความถี่สูงที่สุดในตารางถึง 9,399 ครั้ง (สูงกว่าอันดับ 1 และ 2) แต่ที่ตกมาอยู่อันดับ 3 เป็นเพราะราคาต่อชิ้นหรือยอดบิลเฉลี่ยอาจจะน้อยกว่ากลุ่มความงามครับ
    • monetary (ยอดขายรวม): เป็นตัวจัดอันดับหลัก โดย Health & Beauty ยืนหนึ่งที่ 1,255,695.13 และอันดับ 10 คือ Garden Tools อยู่ที่ 481,009.94
    product_segment by Record Count

    กราฟนี้แสดงผลลัพธ์จากการที่คุณใช้สูตร NTILE(5) และ CASE WHEN ใน SQL เพื่อสับไพ่และจัดกลุ่มสินค้าทั้ง 74 หมวดหมู่ออกเป็นเซกเมนต์ (นับจำนวนหมวดหมู่ด้วย Record Count) ทำให้เราเห็นโครงสร้างสุขภาพของสินค้าทั้งร้านดังนี้ครับ:

    • Star Products (20 หมวดหมู่): นี่คือกลุ่มที่ใหญ่ที่สุดในร้าน มีสินค้าถึง 20 หมวดหมู่ที่เป็นตัวชูโรงหลัก (ขายบ่อย เงินดี เพิ่งขายได้) ต้องรักษามาตรฐานและทำโปรโมชันต่อเนื่อง
    • Dead Stock (19 หมวดหมู่): เป็นจุดระวังสำคัญเชิงธุรกิจ เพราะมีสินค้าถึง 19 หมวดหมู่ที่เข้าขั้น “ค้างคลัง” (ขายไม่ออกมานาน ยอดเงินต่ำ) ฝ่ายบริหารจัดการต้องรีบขยับตัวทำแคมเปญระบายของ
    • General Products (15 หมวดหมู่): สินค้าทั่วไปที่ยอดขายและรายได้สม่ำเสมอในเกณฑ์มาตรฐานกลางๆ ของร้าน
    • Steady Sellers (13 หมวดหมู่): กลุ่มสินค้าที่มาเรื่อยๆ มาเรียงๆ ยอดขายมั่นคง ไม่หวือหวาแต่พึ่งพาได้
    • Fading Giants (6 หมวดหมู่): สินค้ากลุ่มอดีตเคยปัง (เคยขายดีเงินเยอะ แต่ช่วงหลังๆ ค่า recency เริ่มทิ้งห่าง ไม่มีใครสั่งซื้อ) ต้องเข้าไปรีวิวว่าเกิดจากหมดเทรนด์หรือคู่แข่งแย่งตลาด
    • Trending (1 หมวดหมู่): สินค้ากระแสแรงตัวใหม่ มีอยู่ 1 หมวดหมู่ที่ยอดพุ่งขึ้นมาอย่างรวดเร็วในช่วงนี้

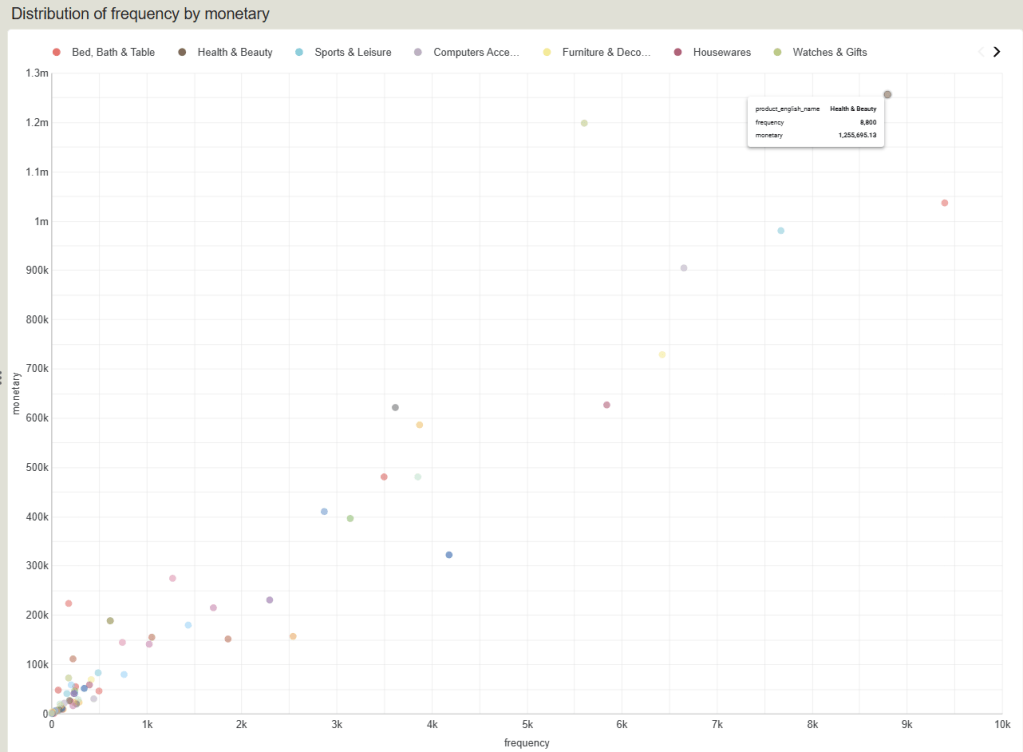
    Distribution of frequency by monetary
    Top-performing product group

    กลุ่มสินค้าท็อปฟอร์ม (ขวาเยื้องบน)

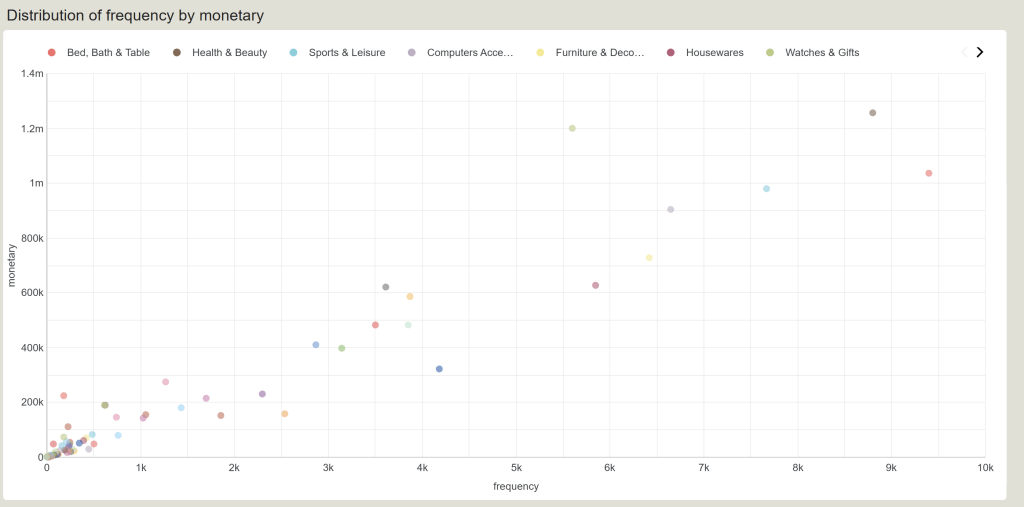
    กลุ่มนี้คือจุดวงกลมที่อยู่อยู่โดดเด่นทางมุมบนขวา มีปริมาณการสั่งซื้อสูงมาก และทำเงินมหาศาล (Star Products):

    • Health & Beauty : ขายดีเป็นอันดับหนึ่งแบบทิ้งห่าง จุดอยู่เกือบถึงแกน X ที่ 8.8k ออเดอร์ และทำเงินสูงเกือบถึง 1.3M
    • Bed, Bath & Table : กลุ่มนี้มีปริมาณออเดอร์ (Frequency) สูงที่สุดในร้านค้าทะลุ 9.4k ครั้ง แม้จะทำยอดเงินรวมรวมได้ประมาณ 1M ซึ่งน้อยกว่ากลุ่มบิวตี้เล็กน้อย แต่ถือเป็นสินค้าปริมาณมาก (Volume Driver) ที่ช่วยดึงทราฟฟิกให้ร้านค้าได้ดีมาก
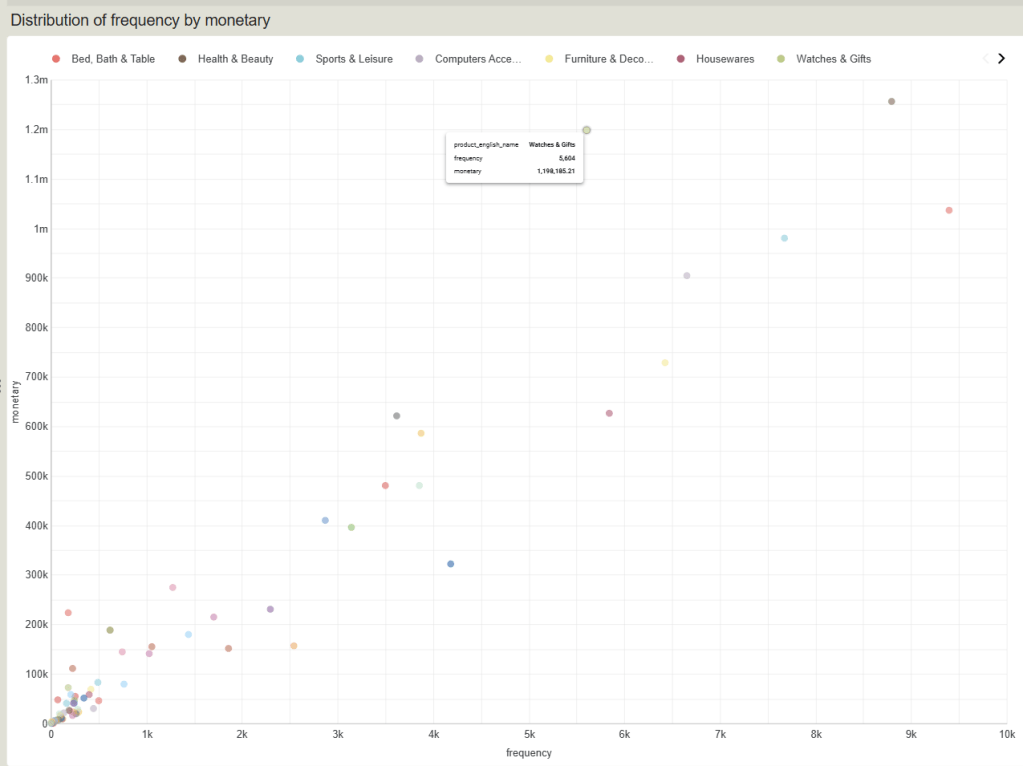
    High Ticket product group

    กลุ่มสินค้า High Ticket (ซ้ายบน – ขายน้อยแต่รวยมาก)

    มองไปที่จุดสีเขียวอ่อนที่ลอยตัวอยู่สูงเด่นบริเวณกลางกราฟค่อนไปทางซ้าย:

    • Watches & Gifts (จุดสีเขียวอ่อนกลางบน): หมวดหมู่นี้มีความถี่ในการสั่งซื้อเฉลี่ยปานกลางอยู่ประมาณ 5.6k ครั้ง (น้อยกว่า Bed, Bath & Table เกือบครึ่งหนึ่ง) แต่กลับทำยอดขายพุ่งสูงถึง 1.2M แซงหน้ากลุ่มอื่นได้อย่างน่าทึ่ง
    • Insight เชิงธุรกิจ: สินค้ากลุ่มนี้มี Average Ticket Size (ราคาต่อชิ้นหรือยอดต่อบิล) ที่สูงมาก ขายไม่ต้องบ่อยแต่ได้เงินเป็นกอบเป็นกำ การทำการตลาดให้กลุ่มนี้ควรเน้นการยิงโฆษณาหาลูกค้าเกรดพรีเมียม (High-value customers) เป็นหลัก
    Concentrated product group

    กลุ่มสินค้ากระจุกตัว (ซ้ายล่าง – สินค้าทั่วไป/หางยาว)

    จะสังเกตเห็นว่าจุดวงกลมส่วนใหญ่ในร้าน (จากทั้งหมด 74 หมวดหมู่) ไปกระจุกตัวหนาแน่นอยู่ตรงมุมซ้ายล่าง (ออเดอร์น้อยกว่า 1k ครั้ง และยอดขายต่ำกว่า 200k):

    • นี่คือภาพสะท้อนของทฤษฎี Long Tail (หางยาว) ในธุรกิจ E-Commerce ครับ คือเรามีสินค้าหลากหลายประเภทมาก แต่ส่วนใหญ่ไม่ได้ทำเงินหวือหวา
    • และในกลุ่มกระจุกตัวนี้เองที่มีสินค้าประเภท Dead Stock ปะปนอยู่จำนวนมาก (ตามที่เราเห็นในกราฟวงกลมรอบที่แล้วว่ามีถึง 19 หมวดหมู่)

    Key Insights from Dashboard

    Revenue Backbone

    ภาพรวมความมั่นคงของรายได้

    บริษัทสร้างยอดขายรวมได้สูงถึง 13.5 ล้าน (13,494,400.74) จาก 99,002 ออเดอร์ ครอบคลุมสินค้า 74 หมวดหมู่ โดยมีสินค้า 5 อันดับแรกที่เกาะกลุ่มทำรายได้สูงใกล้เคียงกัน (เฉลี่ยกลุ่มละ 900K – 1.3M) ชี้ให้เห็นว่าบริษัทมีการกระจายความเสี่ยงของรายได้ที่ดี ไม่ได้พึ่งพาพอร์ตสินค้าใดสินค้าหนึ่งจนเกินไป


    Volume vs. Value Drivers

    โมเดลการสร้างรายได้ที่แตกต่าง

    • จากกราฟ Scatter Plot ด้านล่าง เผยให้เห็นรูปแบบการทำเงินของสินค้ากลุ่มยักษ์ใหญ่ที่ต่างกันอย่างชัดเจน:

    Volume Driver

    กลุ่มเน้นปริมาณ

    • เช่น หมวด Bed, Bath & Table ทำสถิติจำนวนออเดอร์สูงสุดในร้านค้าทะลุ 9,399 ครั้ง (กวาดส่วนแบ่งไป 23.2% ในกลุ่มตัวท็อป) แม้ยอดเงินรวมจะอยู่อันดับ 3 แต่เป็นกลุ่มที่สร้างทราฟฟิกและแรงกระเพื่อมในระบบได้ดีที่สุด

    Value Driver

    กลุ่มเน้นราคา/กำไรต่อชิ้น

    • เช่น หมวด Watches & Gifts มีจำนวนออเดอร์ปานกลางที่ 5,604 ครั้ง (น้อยกว่ากลุ่มแรกเกือบครึ่งหนึ่ง) แต่กลับปั๊มรายได้รวมได้สูงถึง 1.19 ล้าน ขึ้นแท่นเป็นอันดับ 2 ของร้านเนื่องจากราคาต่อบิลสูงมาก

    The Ultimate Star

    กลุ่มแชมป์พรีเมียม

    • หมวด Health & Beauty เป็นกลุ่มเดียวที่ผสานจุดเด่นทั้งสองมิติได้อย่างสมบูรณ์แบบ คว้าแชมป์อันดับ 1 ทั้งในแง่ยอดขายรวม (1.25 ล้าน) และส่วนแบ่งการตลาดกลุ่มตัวท็อป (28.1%)

    Inventory Red Flag

    วิกฤตการณ์สินค้าค้างคลัง

    • แม้หน้าบ้านจะขายดี แต่เมื่อพิจารณาสุขภาพข้อมูลหลังบ้านจากกราฟวงกลม product_segment จะพบว่าบริษัทมีสินค้ากลุ่ม Dead Stock ถึง 19 หมวดหมู่ ซึ่งมีสัดส่วนใหญ่เป็นอันดับที่ 2 ของร้านค้า (เกือบเท่ากลุ่ม Star Products ที่มี 20 หมวดหมู่) สินค้าเหล่านี้มียอดขายต่ำและไม่มีการเคลื่อนไหวมานาน ซึ่งหมายถึงต้นทุนจมในการบริหารจัดการคลังสินค้าที่กำลังสูงขึ้นเรื่อยๆ

    Business Recommendations

    Cross-Category Bundling

    กลยุทธ์ “จับคู่กู้ชีพ”

    • นำหมวดหมู่สินค้ากลุ่ม Dead Stock (19 หมวด) หรือกลุ่ม General Products (15 หมวด) ที่จมอยู่ในโซนซ้ายล่างของกราฟ Scatter Plot มาจัดแคมเปญมัดรวม (Bundling) ร่วมกับสินค้ากลุ่มที่เป็นแม่เหล็กดึงดูดลูกค้าอย่าง Star Products (20 หมวด) เช่น การซื้อครีมบำรุงผิวในหมวด Health & Beauty พ่วงซื้อของตกแต่งบ้านชิ้นเล็กในราคาพิเศษ เพื่อเร่งระบายสินค้าค้างคลัง ขยายพื้นที่โกดัง และเพิ่มอัตราการหมุนเวียนของสินค้า (Inventory Turnover)

    High-Value

    การตลาดแบบเจาะจงกลุ่ม High-Value สำหรับกลุ่มสินค้าราคาสูง

    • สินค้าหมวด Watches & Gifts พิสูจน์แล้วว่าขายน้อยแต่ได้เงินเยอะ (High Ticket Size) ทีมการตลาดไม่ควรเสียเงินยิงแคมเปญหว่านแบบแมส (Mass Marketing) แต่ควรใช้ Data ลูกค้ามาทำ Personalized Marketing คัดเฉพาะกลุ่มที่มีกำลังซื้อสูงเพื่อเสนอขายสินค้ากลุ่มนี้โดยเฉพาะ ซึ่งจะช่วยลดต้นทุนค่าโฆษณา (CAC) แต่สร้างผลตอบแทนสูงสุด (ROAS)

    Subscription / Retention Model

    กลยุทธ์ “ซื้อซ้ำ” สำหรับหมวดหมู่ทราฟฟิกสูง

    • สำหรับหมวด Health & Beauty และ Bed, Bath & Table ที่ลูกค้ามีการสั่งซื้อซ้ำและมีความถี่สูงมาก ควรออกแบบโปรแกรมรักษาฐานลูกค้า (Loyalty Program) หรือระบบบอกรับสมาชิก (Subscription) เช่น การส่งซื้อสินค้าความงามอัตโนมัติทุกๆ 1-2 เดือน พร้อมมอบส่วนลด เพื่อล็อกตัวลูกค้าให้อยู่กับแพลตฟอร์มในระยะยาวและเพิ่ม Lifetime Value (LTV)
    • การทำความสะอาดคลังสินค้าและวินิจฉัยกลุ่ม Fading Giants: สำหรับสินค้า 6 หมวดหมู่ที่อยู่ในกลุ่ม Fading Giants (อดีตเคยเป็นยักษ์ใหญ่ขายดีแต่ปัจจุบันเริ่มเงียบเหงา) ทีมบริหารผลิตภัณฑ์ (Product Owner) ต้องรีบเข้าไปสืบหาต้นตอทันทีว่าเกิดจากสินค้าหมดเทรนด์, มีคู่แข่งเข้ามาตัดราคา หรือเกิดปัญหา Supply Chain เพื่อจะได้ปรับทิศทาง ถ้ารีเทิร์นกลับมาไม่ได้ จะได้วางแผนทำ Clearance Sale ควบคู่ไปกับกลุ่ม Dead Stock เพื่อเอาเงินสดกลับมาหมุนเวียนในบริษัทให้เร็วที่สุดครับ

    Conclusion

    การดำเนินโปรเจกต์ Product Performance Analytics บนข้อมูล Olist e-Commerce ในครั้งนี้ ประสบความสำเร็จในการเปลี่ยนข้อมูลดิบจำนวนมหาศาลในระบบหลังบ้าน ให้กลายเป็นเข็มทิศนำทางธุรกิจที่ชัดเจน ผ่านการผสานพลังเทคโนโลยีระหว่าง BigQuery SQL และ Looker Studio

    จากผลลัพธ์การวิเคราะห์พบว่า โครงสร้างรายได้รวมจำนวน 13.5 ล้าน ของบริษัท มีเสถียรภาพค่อนข้างดีเนื่องจากมีการกระจายความเสี่ยงไปในหลายหมวดหมู่ โดยมีสินค้ากลุ่ม Health & Beauty ทำหน้าที่เป็น ‘The Ultimate Star’ คว้าแชมป์ทั้งด้านยอดขายและปริมาณคำสั่งซื้อ อย่างไรก็ตาม ข้อมูลได้สะท้อนให้เห็นมิติการสร้างรายได้ที่แตกต่างกันอย่างชัดเจนของสินค้าตัวท็อป โดยหมวด Bed, Bath & Table ทำหน้าที่เป็น Volume Driver (เน้นสร้าง Traffic และความถี่สูงถึง 9.4K ครั้ง) ขณะที่หมวด Watches & Gifts ทำหน้าที่เป็น Value Driver (เน้นราคาต่อชิ้นสูง ขายน้อยแต่สร้าง Margin มหาศาล)

    แต่ในขณะเดียวกัน ข้อมูลหลังบ้านได้จุดสัญญาณเตือนภัย (Red Flag) ที่สำคัญ คือการพบสินค้ากลุ่ม Dead Stock สูงถึง 19 หมวดหมู่ ซึ่งมีสัดส่วนใหญ่เป็นอันดับที่ 2 ของร้านค้า ซึ่งหากปล่อยทิ้งไว้จะกลายเป็นต้นทุนจมและลดประสิทธิภาพการทำกำไรของบริษัทในระยะยาว

    เพื่อตอบสนองต่อสิ่งเหล่านี้ โปรเจกต์จึงได้นำเสนอข้อเสนอแนะเชิงกลยุทธ์ 4 แนวทางหลัก คือ

    1. กลยุทธ์ Cross-Category Bundling จับคู่สินค้าค้างคลังพ่วงไปกับสินค้าขายดีเพื่อระบายสต็อก
    2. การทำ Personalized Marketing เจาะกลุ่มกำลังซื้อสูงเพื่อดันสินค้า High Ticket
    3. การสร้าง Subscription/Retention Model ล็อกตัวลูกค้าในกลุ่มสินค้าซื้อซ้ำ
    4. การทำคัดกรองวินิจฉัยกลุ่ม Fading Giants เพื่อดึงกระแสเงินสดกลับมาให้เร็วที่สุด

    โดยสรุปแล้ว โปรเจกต์นี้ไม่ได้เป็นเพียงแค่การทำรายงานสรุปผลตัวเลข (Descriptive Analytics) แต่เป็นการส่งมอบเครื่องมือตัดสินใจทางธุรกิจแบบเชิงรุก (Prescriptive Analytics) ที่ช่วยให้องค์กรพลิกวิกฤตทางคลังสินค้าให้กลายเป็นโอกาสในการสร้างยอดขาย และขับเคลื่อนธุรกิจ e-Commerce ให้เติบโตอย่างยั่งยืนด้วยการใช้ข้อมูลเป็นศูนย์กลาง (Data-Driven Organization) อย่างแท้จริง

    หวังว่าบทความนี้จะเป็นประโยชน์ในเรื่องการใช้ SQL, Google Big Query, Google Sheet, Data Studio และทำให้เข้าใจเรื่อง Key Insight และ Business Recommendation ด้วยครับ
  • 7 Key Insights from Sample Superstore Dataset Analysis

    7 Key Insights from Sample Superstore Dataset Analysis

    สำหรับโปรเจค Sample Superstore Dataset เรียนรู้เพื่อที่จะสามารถดึงข้อมูลจาก Kaggle มาเพื่อวิเคราะห์ต่อใน Python ได้โดยการใช้ library ที่ชื่อ pandas ช่วยวิเคราะห์ข้อมูลออกมาข้อมูลเหล่านี้เราดึงคำสั่งอะไรและได้ประโยชน์อะไรบ้างครับ

    Dataset

    https://www.kaggle.com/datasets/bravehart101/sample-supermarket-dataset


    Github

    https://github.com/Chayanonboo/code-for-articles/blob/main/code_Python/Sample_Superstore_Dataset.ipynb


    Sample Superstore Dataset Analysis

    1. Import data from kaggle
    2. Create file_path
    3. Create variable
    4. Check head
    5. Check information of data
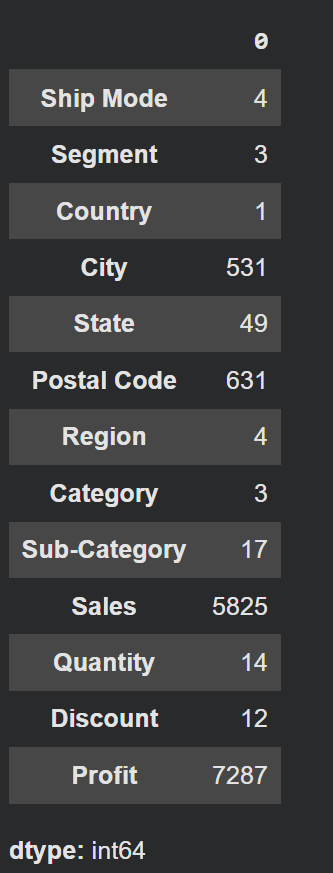
    6. Check nunique Column
    7. Check NA value
    8. Create Question for business
      1. Overall of business
      2. Sub-Category
      3. Segment
      4. Ship Mode
      5. Profit per Region
      6. The weak
      7. State

    Import data from kaggle

    • ต้องมาเริ่มที่ process การดึงข้อมูลมาจาก Kaggle ก่อนครับ
    # Install dependencies as needed:
    # pip install kagglehub[pandas-datasets]
    import kagglehub
    from kagglehub import KaggleDatasetAdapter
    

    เป็นการ import library เพื่อขอใช้เครื่องมือชื่อ kagglehub และขอใช้ตัวแปลงข้อมูล (Adapter) เพื่อเตรียมแปลงข้อมูลที่โหลดมาให้เป็นรูปแบบที่เราต้องการ KaggleDatasetAdapter


    # Set the path to the file you'd like to load
    file_path = "SampleSuperstore.csv"
    

    Create file_path

    ตั้งชื่อไฟล์ว่า file_path จากข้อมูล SampleSuperstore.csv ในหน้า website โดยเป็นการระบุว่าต้องชื่อไฟล์ SampleSuperstore.csv เท่านั้น


    Create variable

    # Load the latest version
    df = kagglehub.load_dataset(
      KaggleDatasetAdapter.PANDAS,
      "bravehart101/sample-supermarket-dataset",
      file_path,
      # Provide any additional arguments like 
      # sql_query or pandas_kwargs. See the 
      # documenation for more information:
      # https://github.com/Kaggle/kagglehub/blob/main/README.md#kaggledatasetadapterpandas
    )
    
    1. df: คือตัวแปรที่จะเก็บข้อมูลทั้งหมดในรูปแบบตาราง (DataFrame) เมื่อโหลดเสร็จแล้ว
    2. KaggleDatasetAdapter.PANDAS: เป็นคำสั่งพิเศษที่บอกว่า “เมื่อโหลดเสร็จแล้ว ช่วยแปลงไฟล์ CSV นั้นให้เป็น Pandas DataFrame ให้เลยนะ” (ไม่ต้องมาสั่ง pd.read_csv() เองทีหลัง)
    3. "bravehart101/sample-supermarket-dataset": นี่คือ “ที่อยู่” หรือ ID ของ Dataset บนเว็บ Kaggle ครับ (เจ้าของคือ bravehart101)

    Check head

    • สามารถเช็คเป็นชื่อ Column แล้วเช็คเป็นชื่อแถวได้
    ## Check Head
    df.head()
    

    Check information of data

    สามารถเช็คเป็นชื่อ Column แล้วเช็คเป็นชื่อแถวได้

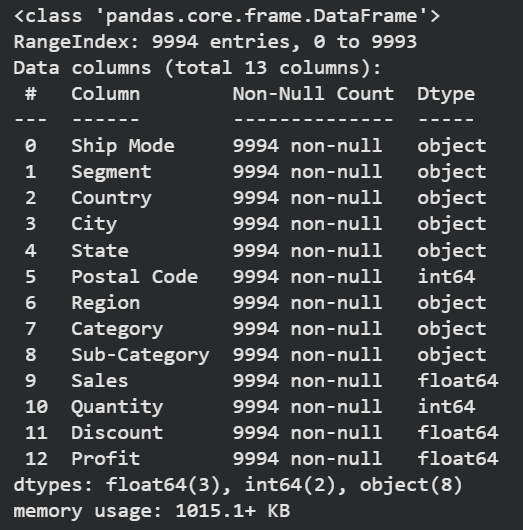
    1. สามารถดูขนาดของข้อมูลได้ว่ามีทั้งหมด 9,994 แถว
    2. สามารถดู missing value ของข้อมูลได้ว่า ตั้งแต่ Column 0-12 ไม่มีช่องว่างเลย
    3. สามารถดูประเภทของข้อมูลได้ว่ามีทั้งหมด 3 ประเภท 1. object คือข้อความที่เป็น text 2. int64 ข้อความจำนวนเต็ม 3. float64 ตัวเลขที่เป็นทศนิยม
    4. สามารถรู้ชื่อ column ได้ตั้งแต่ column (ship_mode จนถึง profit)
    ## Check Info
    df.info()
    
    Information of data

    Check nunique Column

    • สามารถเช็คได้ว่า การนับว่ามีข้อมูลที่ ‘ไม่ซ้ำกัน’ อยู่กี่ตัว
    unique

    Check NA value

    ## check NA Value
    df.isnull().sum()
    
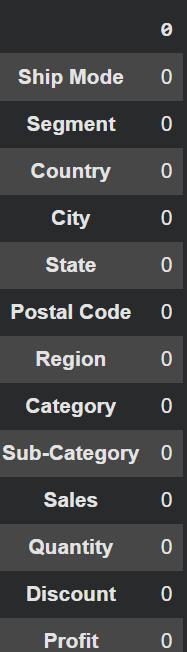
    • สามารถดูข้อมูลว่า ในตาราง df ที่เราสร้างมี column ไหนที่ไม่เท่ากับ 0 เราสามารถ missing_value ให้ column เหล่านั้นได้
    missing value

    Create Question for business

    Overall of business

    • ตลอดทั้ง Dataset บริษัทเรามียอดขายรวม (Sales) และกำไรรวม (Profit) ทั้งหมดเท่าไหร่?
    1. เราไปสามารถไปนับข้อมูลได้ผ่าน column Sales และ Profit ดังนี้ครับ
    ## df.sales all product
    pd.options.display.float_format = '{:,.2f}'.format
    df[['Sales', 'Profit']].sum()
    
    Sale2,297,200.86
    Profit286,397.02
    • สามารถทำให้รู้ได้ว่า Superstore Dataset มีค่า Sale ราคาเท่าไรและมี profit ราคาเท่าไรบ้างครับ

    Sub-Category

    • สามารถทำให้ได้รู้ Sub-Category ทั้งหมดกี่อัน
    # ส่งค่ากลับมาเป็นตัวเลข (int) เช่น 17
    sub_category_unique = df['Sub-Category'].unique()
    print(f"Order: {sub_category_unique}\nCount: {len(sub_category_unique)}")
    
    • Order: [‘Bookcases’ ‘Chairs’ ‘Labels’ ‘Tables’ ‘Storage’ ‘Furnishings’ ‘Art’ ‘Phones’ ‘Binders’ ‘Appliances’ ‘Paper’ ‘Accessories’ ‘Envelopes’ ‘Fasteners’ ‘Supplies’ ‘Machines’ ‘Copiers’]
    • Count: 17
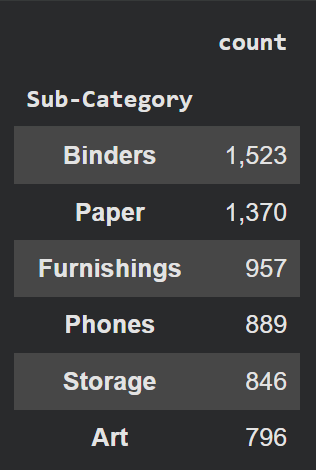
    • สามารถรู้ได้ว่า Sub-Category ไหนที่มีคนสนใจเยอะสุดทั้ง 6 ประเภท
    ## df.sub-Category type
    df['Sub-Category'].value_counts().head(6).to_frame()
    

    Segment

    โดยหากลุ่มลูกค้า (Segment) กลุ่มไหน (Consumer, Corporate, Home Office) ซื้อของกับเราเยอะที่สุด (วัดจากยอดขาย)?

    ## What segment buy most
    sales_by_segment = df.groupby('Segment')['Sales'].sum()
    print(sales_by_segment.apply(lambda x: "{:,.2f}".format(x)))
    
    SegmentSale
    Consumer1,161,401.34
    Corporate706,146.37
    Home Office429,653.15
    • มีการขายของกับ Segment ลูกค้าที่เป็น B2C (Business to Consumer) มากที่สุด รองมาเป็น B2B (Business to Business) อันดับสุดท้ายคือ SOHO (Small Office / Home Office)

    Ship Mode

    • การจัดส่งแบบไหน (Ship Mode) ที่ลูกค้าเลือกใช้บ่อยที่สุด และแบบไหนส่งสินค้าออกไปน้อยที่สุด?
    ## ship frequency
    count_ship_mode = df['Ship Mode'].value_counts().to_frame()
    print(count_ship_mode)
    
    Ship ModeCount
    Standard Class5,968
    Second Class1,945
    First Class1,538
    Same Day543
    • ทำให้รู้ว่าส่วนใหญ่ ลูกค้าชอบของที่มีการขนส่งตามเวลาไปปกติ ส่วนลูกค้าที่ต้องให้ของส่งด่วนนั้นมีน้อยที่สุด

    Profit per Region

    • ภูมิภาคไหน (Region) ทำยอดขายได้สูงที่สุด? และภูมิภาคนั้นทำกำไรได้ดีที่สุดด้วยหรือไม่?
    ## the most Profit form region
    region_sum = df.groupby("Region")[['Sales','Profit']].sum().sort_values(by='Profit', ascending=False)
    print(region_sum)
    
    RegionSalesProfit
    West725,457.82108,418.45
    East678,781.2491,522.78
    South391,721.9146,749.43
    Central501,239.8939,706.36
    • สามารถรู้ได้ว่า Region ที่ขายดีที่สุด คือ Region West ที่ Sales ราคา 725,457.82 และ Profit เยอะสุดที่ 108,418.45 ครับ

    The weak

    • สินค้าหมวดย่อย (Sub-Category) ไหน ที่รวมแล้วทำให้บริษัท “ขาดทุน” มากที่สุด? (Sum Profit ติดลบเยอะสุด)
    ## Sub-Category that make company Loss the most is.
    the_most_loss = df.groupby("Sub-Category")['Profit'].sum().sort_values(ascending=True).head()
    print(the_most_loss)
    
    Sub-CategoryProfit
    Table-17,725.48
    Bookcases-3,472.55
    Supplies-1,189.09
    Fasteners949.51
    Machines3,384.75
    • แสดงว่า สามารถพิจารณาได้ว่า Tables, Bookcases, Supplies ขาดทุนจะต้องปรับราคาและการขายของ 3 สินค้านี้ครับ

    State

    • รัฐไหน (State) ที่เรามียอดขายเยอะ (Top 10) แต่กำไรกลับติดลบ? (ยอดขายหลอกตาให้รู้สึกว่า Sale เยอะ!)
    ## the most state most sale but profit less
    the_most_state = df.groupby("State")[['Profit','Sales']].sum().sort_values(by='Profit', ascending=True)
    print(the_most_state)
    
    StateProfitSales
    Texas-25,729.36170,188.05
    Ohio-16,791.3878,258.14
    Pennsylvania-15,559.96116,511.91
    Illinois-12,607.8980,166.10
    North Carolina-7,490.9155,603.16
    Colorado-6,527.8632,108.12
    Tennessee-5,341.6960,661.87
    Arizona-3,427.9235.282.00
    Florida-3,399.3089,473.71
    Oregon-1,190.4717,431.15
    • sort_values(by=’Profit’, ascending=True) ทำให้รู้ว่ารัฐที่ขาดทุนมีทั้งหมด 10 รัฐดังนี้ โดยเรียงจากขาดทุนมากไปขาดทุนน้อย
    1. Texas
    2. Ohio
    3. Pennsylvania
    4. Illinois
    5. North Carolina
    6. Colorado
    7. Tennessee
    8. Arizona
    9. Florida
    10. Oregon

    จากที่ได้วิเคราะห์มาเบื้องต้นก็ทำให้ได้รู้ว่า

    1. ธุรกิจมียอดขายรวม 2.3 ล้านเหรียญ โดยมี Region West และลูกค้ากลุ่ม Consumer เป็นตัวแบกหลักที่สร้างยอดขายและกำไรสูงสุด
    2. สินค้าหมวด Tables และรัฐ Texas คือตัวถ่วงที่น่าเป็นห่วงที่สุด เพราะแม้จะมียอดขายสูงแต่กลับสร้างผลขาดทุนหนักที่สุด (Sales สูงแต่ Profit ติดลบ)
    3. ข้อมูลชุดนี้ชี้ให้เห็นว่า “ยอดขายเยอะไม่ได้แปลว่ากำไรดี” เสมอไป โดยเฉพาะในกลุ่มสินค้าเฟอร์นิเจอร์บางชนิดและบางรัฐที่ต้องเร่งปรับปรุงโครงสร้างราคาครับ
    • หวังว่าบทความนี้จะเป็นประโยชน์ในเรื่องการใช้ pandas ใน Python เบื้องต้นกับทุกท่านครับ ขอบคุณครับ

  • 5 Sample Case For Intro to Data Science

    5 Sample Case For Intro to Data Science

    เป็นบทความที่เขียนเพื่อที่จะช่วยให้สามารถเข้าใจตัวอย่างสำหรับข้อมูลที่มีในปัจจุบันว่าจะมีประโยชน์สำหรับนำไปประยุกต์กับธุรกิจในชีวิตจริงได้ในรูปแบบต่างๆ ตามที่เคสตัวอย่างที่จะนำมาเล่าสู่การฟังดังนี้


    Intro to Data Science for 5 Case

    1. Case Study 1 – Target
      1. Case 1 : Check Pregnant Girl
        1. Threshold Criteria
        2. Confusion Matrix
      2. Case 2 : A person infected with COVID-19
      3. Case 3 : Churn Prediction
    2. Case Study 2 – Tesco
      1. Case 1 : Tesco/ Sainsbury’s
        1. Evina Dunn and Clive Humby
      2. Case 2 : Loyalty Program 7-11
    3. Case Study3 : Netflix
      1. Case 1 : CEO Netflix
        1. Rule of Reed Hastings
      2. Problem Netflix Case
    4. Case Study 4 : Cambridge Analytica
      1. Case 1 : Brexit
    5. Case Study 5 : Moneyball
      1. Case 1 : Coach and Economist

    Case Study 1 – Target

    Pregnancy prediction การที่จะสามารถทำนายผู้หญิงคนไหนท้อง หรือ ไม่ท้อง สามารถดูได้จากการซื้อสินค้าของผู้หญิง

    • โดยมี 3 พฤติกรรมหลักที่ผู้หญิงเปลี่ยนดังนี้
    1. การกิน
    2. การซื้อของ
    3. การดูแลตัวเอง
    Pregnant
    • จากข้อมูลที่ถูกเก็บทำให้สามารถบอกได้ผู้หญิงคนน่าจะท้องจึงทำให้มีส่ง Coupon ส่วนลดสินค้าสำหรับคนท้องไปให้เป็นเรื่องเวลา 9 เดือน เพื่อเพิ่มโอกาสที่ลูกค้าอยากจะซื้อสินค้าของแบรนด์

    ทำให้มีเรื่องกับครอบครัวบางครอบครัวเพราะไม่รู้ว่าลูกผุ้หญิงที่บ้านตัวเองท้อง ส่ง coupon ไปหาเด็กมัธยมผู้หญิง

    Target รู้ได้ว่าผู้หญิงคนนี้ท้องก่อนคุณพ่ออีก

    1. เพราะดูจาก Pattern การซื้อสินค้าของเด็กคนนั้น
    2. 3 เดือนแรกเมื่อผู้หญิงรู้ว่าตัวเองท้อง จะเปลี่ยนไปใช้แชมพูที่ไม่มีกลิ่น เริ่มซื้อ calcium สารอาหารดีๆ
    3. 6 เดือนซื้อครีมทากันท้องลางมาเพิ่ม
    4. 9 เดือนซื้อ big cotton สำลี big pack
    Check Pregnant Girl

    Case 1 : Check Pregnant Girl

    • ถ้าอยากรู้ผู้หญิงคนไหน ท้องบ้าง ไปตั้ง boot หน้า Target คือ baby shower boot

    ให้ลูกค้ากรอกชื่อและนามสกุล เบอร์โทรที่อยู่จะให้ Coupon discount 20-30%

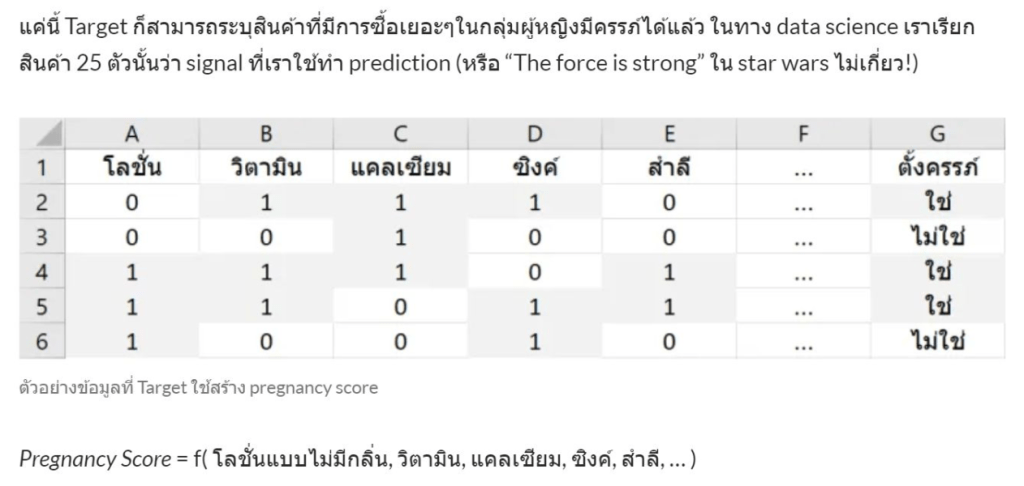
    ColumnData
    Column A-Eข้อมูลใน database ในบริษัท with binary data (0,1) ทำนาย Column G
    Column Gข้อมูลใน baby shower booth
    Pattern Coupon
    • set threshold = 0.5 default to predict that women get pregnant.
    • ทีมการตลาดจะตัดสินใจส่ง decision ให้ทีมการตลาด

    การใช้ Threshold แบบไหนถึงจะดี


    Threshold Criteria

    Quality of ThresholdResult
    Threshold สูงSite ของ Audience น้อยลง
    Threshold ต่ำSite ของ Audience มากขึ้น
    • ต้องตรวจสอบต้นทุนการส่ง Coupon ไปที่บ้านประกอบการพิจารณาเนื่องจากมีต้นทุน

    Trade off ความคุ้มค่าระหว่าง แจกคูปองเยอะกับคูปองน้อย แล้วลูกค้าซื้อกลับเยอะหรือไม่


    Confusion Matrix

    Confusion Matrix คือตารางที่ใช้ในการประเมินโมเดล(Classification Model) สำหรับผลลัพธ์จริง (Actual Values) และผลลัพธ์ที่โมเดลทำนาย (Predicted Values) แล้วนำมาเปรียบเทียบกัน

    1. True Positive (TP): ค่าบวกจริง
    • คือ กรณีที่โมเดล ทำนายว่าเป็นบวก (ท้อง) และ ความเป็นจริงก็เป็นบวก (ท้องจริง)

    2. True Negative (TN): ค่าลบจริง

    • คือ กรณีที่โมเดล ทำนายว่าเป็นลบ (ไม่ท้อง) และ ความเป็นจริงก็เป็นลบ (ไม่ท้อง)

    3. False Positive (FP): ค่าบวกเท็จ Type I Error

    • คือ กรณีที่โมเดล ทำนายว่าเป็นบวก (ท้อง) แต่ ความเป็นจริงเป็นลบ (ไม่ท้อง)

    4. False Negative (FN): ค่าลบเท็จ Type II Error

    • คือ กรณีที่โมเดล ทำนายว่าเป็นลบ (ไม่ท้อง) แต่ ความเป็นจริงเป็นบวก (ท้อง)
    Prediction vs Actual

    Case 2 : A person infected with COVID-19

    • ช่วงโควิด ระบาดใหม่ ปลายปี 2019 คนป่วยไปโรงพยาบาลเป็น 100 คน ตรวจแล้วควรใช้ threshold ต่ำหรือสูงดีกว่า ?
    • ควรใช้ต่ำ เพราะโรงพยาบาลต้องการให้คนอยู่โรงพยาบาลมาก threshold 30% ก็ควรให้อยู่โรงพยาบาลเยอะกรณีผู้ป่วยโควิดยังน้อย
    • ถ้าเกิดเตียงเริ่มเต็ม ต้องตั้ง threshold 70% เพื่อให้คนอยู่โรงพยาบาลน้อยๆ ในกรณีโควิดระบาดมาก

    threshold สูงต่ำ ไม่ได้อยู่ที่ model แต่อยู่ที่สถานการณ์ประกอบด้วย


    Case 3 : Churn Prediction

    Churn Prediction
    • หาว่าใครมีแนวโน้มจะเลิกใช้แบรนด์หรือไม่ ?
    • ถ้ารู้ว่าลูกค้าที่มีแนวโน้มจะยกเลิกใช้บริการ Dtac จะแก้ไขยังไง
    • โทรหา offer promotion, โปรลับเพื่อไม่ให้คนเลิกใช้บริการ
    • prescriptive analytic
    • เก็บ data เดือน 1 – เดือน 3 ทดลอง เดือน 4 deploy model เดือน 5-7 แล้วทำนาย model ไปเรื่อยๆ

    Case Study 2 – Tesco

    Case Study : Tesco
    • TESCO เป็น Target ของ (Retail คือ การขายสินค้าหรือบริการโดยตรงให้กับผู้บริโภคคนสุดท้าย)
    • สมัย Tesco เมื่อ 30 ปีที่แล้ว 1990 Tesco ยังไม่ใช่เจ้าตลาด ณ ปัจจุบัน
    • Brand เบอร์หนึ่งตอนนั้นคือ Sainsbury’s (เซนส์เบอรีส์)

    Case 1 : Tesco/ Sainsbury’s

    • สมัยก่อน ที่ Sainsbury สามารถใช้เงินซื้อ 5 ปอนด์ ซื้ออาหารกล่องและ Spaghetti ที่กินได้ถึง 3 มื้อเลยครับ อยู่ได้ 2 วัน ปี 1990
    • TESCO จึงพยายามจะแซงหน้า Sainsbury’s (เซนส์เบอรีส์) ทำไงก็แซงหน้าไม่ได้
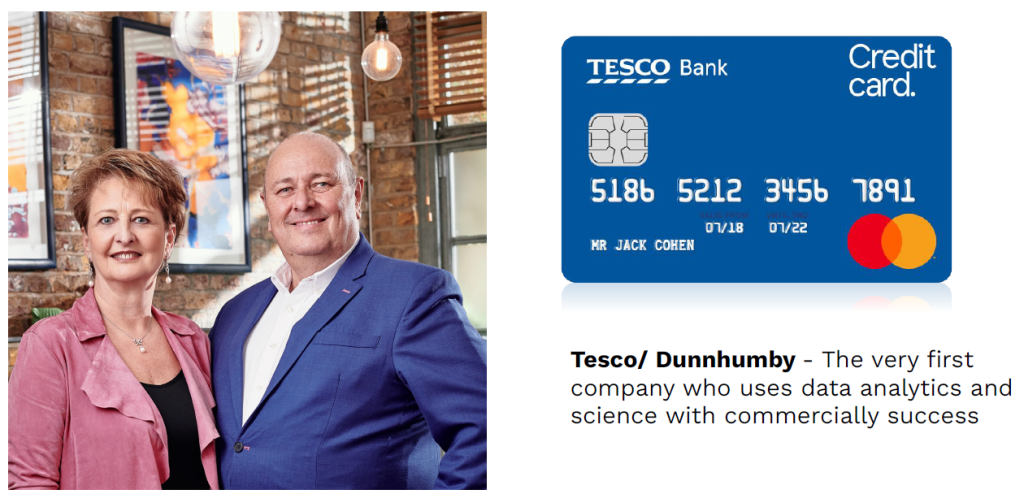
    • TESCO เลยไปหา 2 สามี ภรรยาจากรูปด้านบนนี้มาเพื่อคิดกลยุทธ์ใหม่ๆ ชื่อ Evina Dunn and Clift Country

    Evina Dunn and Clive Humby

    • รวมชื่อกัน เป็น Dunnhumby เสนอ Campaign เข้าไปทำกับ Tesco โดยสร้างเป็น Loyalty Campaign เพื่อให้ user มาสมัครได้แล้วใช้ Loyalty Club Card แล้วเก็บสะสมแต้มได้
    • พอทำงานได้ 3-4 เดือน เอาข้อมูลไปที่เก็บได้จากลูกค้าให้ผู้บริหารฟัง จึงได้ข้อมูล 5 part นี้ที่ควรจะพัฒนา
    5 Part

    วิเคราะห์ข้อมูลแบบนี้ ทำอะไรได้บ้าง

    • สกิลการตั้งคำถามคือ การที่จะสามารถทำให้รู้แนวทางในการวิเคราะห์ข้อมูลต่อได้
    1. จงหาว่า สาขาไหนขายปริมาณเยอะสุด
    2. จงหาว่าลูกค้า Top 10 ที่ซื้อสินค้าเยอะสุด คือใครบ้าง สาขาไหน ซื้อเยอะ ช่วงเวลาในการซื้อ
    3. วันที่สามารถทำให้เรารู้ได้ วันที่ที่ลูกค้ากลับมาซื้ออีกครั้ง เพื่อดูความถี่ในการซื้อของลูกค้า

    Case 2 : Loyalty Program 7-11

    • ยิ่งลูกค้าคนไหน ซื้อของให้เยอะก็จะยิ่งส่ง Coupon Size ใหญ่ไปให้ลูกค้าเหล่านั้นได้เลย
    • ลูกค้าแต่ละคน สร้าง Value ให้โทรศัพท์ไม่เท่ากัน ก็ควรจะให้ Offer ต่อลูกค้าที่ไม่เหมือนกัน
    • High Value Receive Good offer, Low Value Receive Bad offer

    Personalization คือ กระบวนการปรับเปลี่ยนประสบการณ์, เนื้อหา, ผลิตภัณฑ์, หรือบริการ ให้มีความเหมาะสมและตรงกับความต้องการ, ความสนใจ, ลักษณะเฉพาะของแต่ละลูกค้า


    Case Study3 : Netflix

    Netflix
    • เคสนี้เป็น Case ที่ไม่ประสบความสำเร็จ
    • ไม่ใช่ทุก Project ที่เราทำขึ้นมาจะได้อยู่ใน Production ก็มีหลาย Project ที่ Fail ไปเหมือนกัน

    Case 1 : CEO Netflix

    • CEO Netflix เคยเปิดการแข่งขันทั่วโลก ใครก็ตาม Build model แนะนำหนัง Recommendation ได้ดีกว่า Netflix 10% ขึ้นไป เอาเงินไปเลย 1 ล้านเหรียญ
    CEO Netflix
    • คล้ายกับการแข่ง hackathon เป็นการแข่งเพื่อหา Idea ใหม่ๆ
    • Netflix ทำ Website แล้ว Summit คะแนนเลย หนังแต่ละอันที่ถูกผลิตขึ้นมาได้คะแนนเท่าไรบ้าง
    • เวลาแนะนำหนังไป โชว์หนังเรื่องนึงแล้วมีคนกดเข้าไปดู แสดงว่าหนังเรื่องนั้นดีแล้วได้ Accuracy 100%
    • แต่ถ้าโชว์หนัง 100 เรื่องแล้วคนดู 50 เรื่อง แสดงว่า Accuracy 50/100 = 50%

    Rule of Reed Hastings

    • ใครที่สามารถ Build Algorithm ที่ทำงานได้ดีกว่า Data Scientist Netflix 10% จะเอาเงินไป 1 ล้าน
    • ผ่านไป 3-4 ปี ทีมที่ 1-5 ที่ทำแข่งได้ใกล้มารวมตัวกันแล้วตั้งทีมแล้วทีมทำนายสำเร็จ

    ทำให้ Model สามารถชนะ Netflix แต่ไม่สามารถเอาไปใช้จริงได้


    Problem Netflix Case

    Failed Netflix
    • Business Outcome กับ Model Output แต่ไม่สอดคล้องกัน จึงไม่สามารถใช้จริงได้
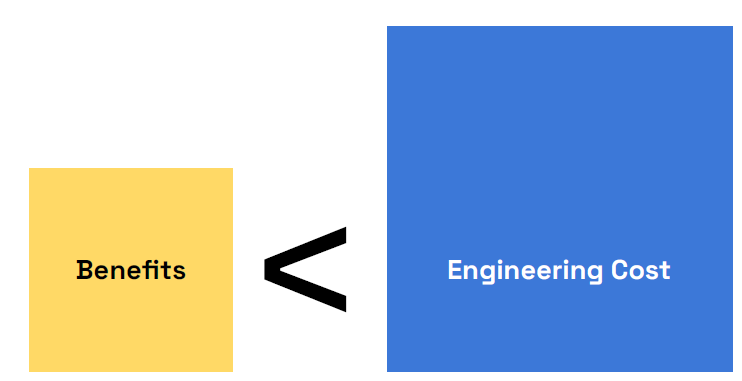
    • ต้นทุนของ Model ที่จะใช้เปลี่ยนโครงสร้างหลังบ้านใช้เยอะเงินมาก จึงไม่คุ้มกับรายได้ที่ได้รับ
    • ระยะเวลาที่ใช้ในการเปลี่ยนนานเกินไป จึงไม่คุ้มค่า
    Benefits < Engineer Cost

    Concept เรื่องความเร็วใน Deliver service ผ่าน Application แล้วส่งผล predict ขึ้นไปบนโทรศัพท์มือถือลูกค้า

    • เช่น Netflix มี Model แนะนำหนังให้ลูกค้า SLA (Service Level Agreement หรือ ข้อตกลงระดับการให้บริการ) ใช้เวลา 3 วินาที
    • เวลาลูกค้า summit service level ที่ 3 วินาที ให้กลายเป็น 1 วินาที แล้วลดความเร็วจะได้มั้ย
    • แต่ต้นทุนทำคอมพิวเตอร์เราส่งข้อมูลมา 50 ล้านก็รายได้กลับมาที่ 10 ล้าน

    Case Study 4 : Cambridge Analytica

    Cambridge Analytica
    • เป็น Case Study เรื่อง Project Almo
    • เป็น project Alamo ที่ Donald Trump ทำไว้เทื่อ 8 ปีที่แล้ว
    • ใช้ต้นแบบจาก Obama เลยว่า พื้นที่ไหนควรใช้ในการหาเสียงแล้วสามารถทำคะแนนได้

    Project Almo เป็นการสร้างฐานข้อมูลผู้มีสิทธิ์เลือกตั้งที่สร้างขึ้นสำหรับแคมเปญหาเสียงเลือกตั้งประธานาธิบดีของโดนัลด์ ทรัมป์ ในปี พ.ศ. 2559

    ทำหนังใน Netflix ขึ้นมาเรื่อง The Great Hack

    • โดย Database จะมีชื่อ เบอร์โทร นามสกุลแล้วก็ที่อยู่ และพรรคการเมืองที่ชอบของคนอเมริกาหลุดออกมา

    จากการดึง API จาก facebook โดยที่ Facebook สั่งให้ลบ แต่ Cambridge ไม่ลบ


    Case 1 : Brexit

    • Carole Cadwalladr เคยไปทำข่าวสอบถามว่าชาว Wale ที่ Ebbe vale ว่า ให้อังกฤษและสหราชจักรเยอะมากว่าควรออกจาก Brexit มั้ย
    • Brexit คือการโหวตอังกฤษออกจาก EU
    • เพื่อให้คนอยากออกจาก Brexit แต่เมือง Ebbe vale ได้เงินสนับสนุนจาก EU เยอะมาก แต่คนโหวตออกเยอะ จึงรู้สึกแปลกใจ
    • เลยเดินไปถามร้านค้าทั่วไปทำไมถึงอยากออก เพราะโดน Immigrant แย่งงานเยอะมาก แต่พอไปดูข้อมูลจริง มีคนต่างชาติมาแย่งงานน้อยมาก

    คนส่วนใหญ่เห็นข้อมูลนี้มาจาก Facebook


    Case Study 5 : Moneyball

    Money Ball
    • Billy Bean เป็นผู้จัดการทีมของทีมท้ายตารางของ Baseball

    ทีมไม่มีเงินแล้วไม่รู้ทำยังไง จึงเอาเงินมาจ้างนักเศรษฐศาสตร์


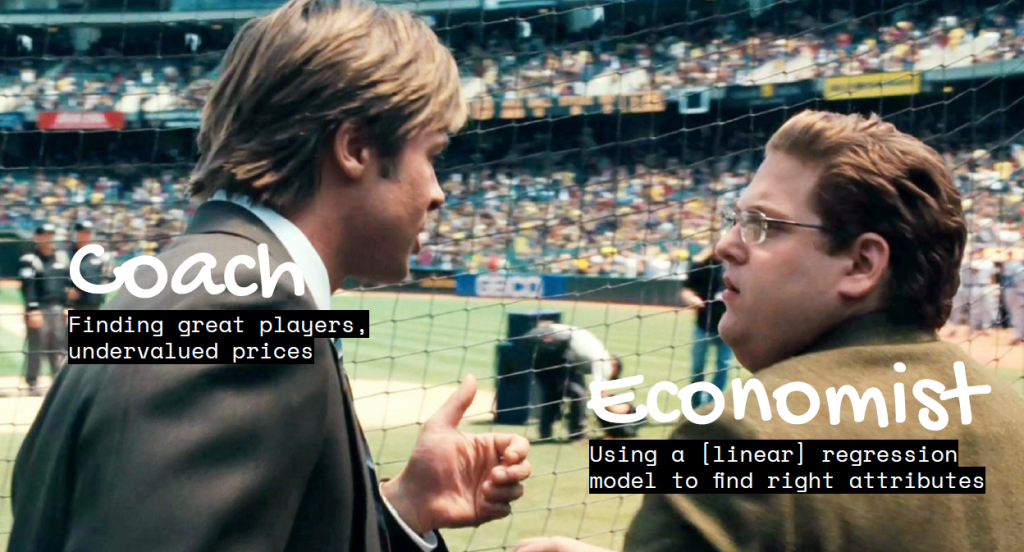
    Case 1 : Coach and Economist

    Coach and Economist
    • สร้างค่า Regression เพื่อรู้ว่าทำไง ถึงสามารถตัวแปรไหนสามารถข่วยให้ชนะได้
    • โดยนำตัวแปรที่วิเคราะห์ออกมาว่าไปหานักกีฬาที่มี 5 Skill นี้ดี แต่ค่าตัว under value player

    แล้วพา Oakland Athletics สร้างประวัติศาสตร์ชนะ 20 เกมในประวัติศาสตร์ Baseball America


    ข้อมูลเป็นสิ่งที่สำคัญในโลกอนาคตมากดังนั้นจากเคสตัวอย่างทั้ง 5 เคส แสดงเห็นว่าปัจจุบันใครยิ่งรับรู้ข้อมูลได้มากและถูกจะยิ่งประสบความสำเร็จในชีวิตได้มากขึ้น


    ขอบคุณคอร์ส Graduation Day จาก Data Science Bootcamp 11 DataRockie : https://data-science-bootcamp1.teachable.com/courses/enrolled/2684443


  • 20 Ideas from Essential Statistics 101

    20 Ideas from Essential Statistics 101

    สถิติเป็นวิชาที่เกี่ยวกับการรวบรวม จัดระเบียบ วิเคราะห์ และตีความข้อมูล เพื่อนำไปสู่การตัดสินใจและสรุปผลที่มีหลักเกณฑ์ สถิติมีบทบาทสำคัญในการศึกษา วิจัย และการตัดสินใจในหลากหลายสาขา เช่น วิทยาศาสตร์ สังคมศาสตร์ ธุรกิจ การแพทย์และการตัดสินใจต่างในชีวิตประจำวัน การเรียนรู้สถิติจะช่วยให้เราเข้าใจโลกและตัดสินใจได้อย่างมีเหตุผลมากขึ้น


    Essential Statistics

    1. Why we start to learn statistics?
      1. Case analysis of listening to Lisa’s music
      2. Started Statistic
    2. Sample Statistical Case
      1. Case Cooking Food
      2. Case Stock
      3. Case Relationship
    3. Sampling
    4. Probability Sampling
    5. Simple Random Sampling
      1. Case Lottery
      2. Case Simple Random Sampling in Excel
    6. Systematic Random Sampling
    7. Cluster random Sampling
    8. Stratified Random Sampling
      1. Case Beer
      2. Case Population Census
    9. Non Probability Sampling
    10. Convenience Sampling
      1. Case Google Form
    11. Snowball Sampling
      1. Case Ivory
    12. Data Collection
      1. Sample Size
      2. Diminish Return
    13. Margin of Error vs Sample Size vs Budget
    14. Confidence Level vs Sample Size
    15. Descriptive Stat
    16. Central tendency
      1. Mean
      2. Median
      3. Mode
    17. Spread Tendency
    18. Position
    19. Process of Distribution
      1. Normal Distribution
      2. Skewed Left Distribution
      3. Skewed Right Distribution
    20. Outlier

    Why we start to learn statistics?

    • โดยวิชาสถิติเริ่มต้นมีมาตั้งแต่ 300-400 ปีที่แล้ว
    TypeDefinition
    Populationกลุ่มประชากรทั้งหมดที่เราสนใจศึกษา
    Sampleกลุ่มตัวอย่างที่สุ่มมาจากประชากร
    Samplingกระบวนการในการเลือกกลุ่มตัวอย่างจากประชากร
    Generalizationการนำผลที่ได้จากการศึกษากลุ่มตัวอย่าง ไปอ้างอิงถึงประชากร
    • โดย สถิติมักเริ่มจาก population หรือประชากรทั้งหมด

    Case analysis of listening to Lisa’s music

    โดยประมาณคนไทยว่ามี 70 ล้านคน ถ้าอยากรู้คนไทยฟังชอบเพลง lisa กี่คนต้องทำยังไงบ้าง

    1. การที่จะเข้าถึงคนไทย 70 ล้านคนเป็นไปไม่ได้เลย จึงสามารถวัดความชอบว่าคนไทยชอบเพลง lisa มั้ยสามารถวัดได้โดยสุ่มตัวอย่างขึ้นมา Sample และวิธีในการสุ่มตัวอย่างเรียกว่า Sampling
    2. หากสุ่มตัวอย่างมา 100 คน โดยหากต้องรู้ว่าการสุ่มแบบไหนสามารถ Represent ประชากรทั้งหมดได้จริง เรียกว่า Generalization

    สิ่งสำคัญที่สุดคือ วิธีการสุ่มตัวอย่าง แบบไหนถึงจะตัวอย่างที่ represent ประชากรที่ถูกกลุ่มและมีคุณภาพ


    Started Statistic

    Small Data —> Big Data

    เป็นศาสตร์การเรียนรู้ที่เกิดจากกลุ่มตัวอย่างที่ถูกสุ่มขึ้นมา เพราะทุกคนไม่มีใครสามารถเข้าถึงทุกข้อมูลในโลกใบนี้จึงมีการสุ่มตัวอย่างขึ้นมา


    Sample Statistical Case

    Case Cooking Food

    Method

    1. อย่างเช่นการทำกับข้าว โดยการตั้งคำถามเกี่ยวกับน้ำแกง สามารถถามอะไรได้บ้าง
    2. เช่นซุปเห็ด ทำยังไงให้รสชาติออกมาอร่อย
    3. ถ้าอยากรู้ว่าซุปเห็ดสับอร่อยโดยการใช้ช้อนในการชิมสุ่ม Sampling มาเพื่อชิมรสชาติ
    4. หากชิมแล้วอร่อย จะสามารถสรุปผลกลับไปยังทั้งหม้อได้เลยว่า ทั้งหม้ออร่อยด้วย
    Case Mushroom Soup

    Case Stock

    • หากมีหุ้นชนิดหนึ่งที่เราต้องการลงทุนซื้อ จำเป็นต้องศึกษาข้อมูลของบริษัทด้วย
    Case Stock
    1. เราสามารถรู้ว่าข้อมูลได้บางอย่างจากบริษัทเหล่านั้น ซึ่งเหล่านั้นมาจากข้อมูล Sample
    2. เราสามารถทำ Sampling กลับหาหุ้นได้เลยว่า หุ้นตัวนี้จะมีแนวโน้มที่ดีขึ้นจากข่าวอะไรได้บ้าง บริษัทมีผลประกอบการณ์เป็นอย่างไรบ้าง ส่งผลต่อหุ้นมั้ย

    Case Relationship

    • สมมุติผู้หญิงคนหนึ่งคุยกับผู้ชายคนหนึ่งอยู่จะรู้ได้ไงว่า ผู้ชายที่คุยอยู่เป็นคนดี มั้ย
    1. เริ่มถามเพื่อนของผู้ชายว่า ผู้ชายที่เรากำลังคุยอยู่โอเคมั้ย
    2. ผู้ชายคุยกับผู้หญิงหลายคน
    3. หน้าที่การงานของผู้ชาย
    4. ผู้ชายกินเหล้าสูบบุหรี่

    หากเก็บข้อมูลมา 3 เดือนจะสรุปได้ว่าคนนี้โอเคที่จะคบกันเป็นแฟนได้

    Case Relationship

    Things to watch out for in a relationship

    1. ตอนเก็บ Sampling ผู้ชายคนนี้ 3 เดือนแรกดีกับเราหมดเลย ซื้อ Chocolate ซื้อดอกไม้ ให้ของขวัญ ถูบ้าน ซักผ้าให้
    2. ช่วงหมดโปรผ่านไป 3 ปีอาจจะไม่เหมือนเดิม เพราะหมดช่วงโปรสิ่งเหล่านั้นจะน้อยลงด้วยเคยชิน
    3. โดยที่เราไม่รู้จักคนที่คุยด้วยดีพอจนกว่าจะต้องไปตื่นเจอกันทุกเช้าเพื่อที่จะสามารถรู้ว่า lifestyle เข้ากันได้หรือเปล่า
    4. อย่างเช่น ตอนนอนต่างคนต่างกรนจนรำคาญกัน

    คู่ชีวิตเรา มองข้อเสียของกันแล้วรับกันได้มั้ย แต่ที่มีคู่ชีวิตก็ดีสามารถเป็นกระจกเพื่อส่องข้อดี ข้อเสียของอีกฝ่ายได้


    Sampling

    Type of SamplingDefinition
    Probability Samplingการสุ่มแบบใช้ความน่าจะเป็น
    Non-Probability Samplingการสุ่มแบบไม่ใช้ความน่าจะเป็น

    ในชีวิตจริงเรามักใช้การสุ่มแบบใช้ความน่าจะเป็นมากกว่า


    Probability Sampling

    Simple Random Sampling

    การสุ่มตัวอย่างแบบง่าย คือ การสุ่มตัวอย่างที่สมาชิกทุกคนในประชากรมีโอกาสเท่าๆกัน ในการถูกเลือกเข้ามาเป็นกลุ่มตัวอย่าง


    Benefits of Probability Sampling

    1. หากจะใช้กระบวนการนี้ ต้องมีรายชื่อคนไทยทุกคนอยู่ใน program R หรือ Spreadsheet แล้วสุ่มตัวอย่างมา 400 คน
    2. Simple random Sampling ทำได้กับระบบปิดเท่านั้น คนใน Community Discord 400 คน โดยสุ่ม 40 คนเพื่อดู model ว่า แอดทอยสอน Data ใน Discord มั้ย

    Case Lottery

    1. เช่น สุ่มคง 100 คนจากคน 1 คน ทุกคนมีโอกาสถูกสุ่มเข้ามา 1%
    2. จับการรางวัล lottery โอกาสได้เบอร์ 0.1% เพราะมีเบอร์ 0-9
    Case Lottery

    Case Samsung

    Samsung ลดจากการ WFH 1 วันต่อสัปดาห์ —> WFH 1 วันต่อ 2 สัปดาห์ เพราะไม่ได้ติดโควิดเหมือนสมัยก่อน

    • ตัวอย่างเช่นนโยบาย ที่อยากให้ตรวจสอบว่าพนักงาน 3000 คนบริษัทอยาก WFH มั้ยจึงสุ่มสำรวจในแผนก 30 คนเพื่อ Refer ถึงพนักงานโดยรวมเพื่อทราบว่าพนักงานต้องการ WFH มากแค่ไหน

    Case Simple Random Sampling in Excel

    สมมุติการสุ่มแต่ละครั้งโดยเลือก 3 คนจาก 5 คใน Excel ดังนี้

    =RAND()
    
    Case Simple Random Sampling in Excel
    1. แต่ในความจริงถ้าจะทำสุ่มประชากรของประเทศไทย ต้องมีรายชื่อทั้งหมด 70 ล้านคนแล้วสุ่มจึงทำยาก
    2. Facebook สามารถทำ Random Sampling ได้เลยเนื่องจากมีข้อมูลลูกค้าที่อยู่ในประเทศนั้นๆ
    3. โดย Survey ที่ brand ในแต่ละประเทศได้รับจะโอเคเพราะมีข้อมูล User เยอะ

    Systematic Random Sampling

    • เป็นการสุ่มแบบมีระบบที่วางไว้หรือเป็น pattern ตั้งไว้ โดยเลือกสุ่ม 3 คน

    อยากสุ่มคนที่ 1 แล้ว เว้นการสุ่ม 2 คน หลังจากนั้นสุ่มคนที่ 4 ทำแบบนี้ไปเรื่อยๆ จนเป็นระบบดังรูปด้านล่าง

    =RAND()
    
    Case Systematic Random Sampling

    Cluster random Sampling

    1. เป็นการแบบสุ่มแบบแบ่งกลุ่มไว้ก่อน 3 กลุ่ม แล้วสุ่มตาม Cluster
    2. สุ่มเลข 1 ถึง 3 หากสุ่มได้ Cluster ไหนก็ให้เลือก Cluster ในการสุ่มตัวอย่างทำ Survey
    =RANDBETWEEN(1,3)
    
    Case Cluster random Sampling

    Stratified Random Sampling

    เป็นวิธีการสุ่มตัวอย่างที่แบ่งประชากรออกเป็นกลุ่มย่อยๆ (strata) ตามลักษณะที่สนใจ (เช่น เพศ อายุ ระดับการศึกษา) แล้วสุ่มตัวอย่างจากแต่ละกลุ่มย่อย โดยแต่ละกลุ่มย่อยจะมีสัดส่วนเท่ากับสัดส่วนในประชากร

    Stratified Random เป็นวิธีการที่มีใช้ในงาน Market & Research เยอะที่สุด


    Case Beer

    • อยากรู้ว่าคนไทยชอบ กินเบียร์ กี่คน ให้สุ่มจากคน 1,000 คน

    Sample size จะถูกจำกัดด้วย 2 เรื่องคือ Time and Budget

    Calculate Budget

    1. เช่นมีงบการเงิน 500,000 บาท
    2. Cost Per Interview = 500,000/1,000 = 500 บาทต่อคน แล้วคำนวณว่าเป็นไปได้มั้ย
    3. โดยที่เราจะต้องคำนวณ Margin ให้กำไร 40-50%
    4. เช่น CPI 500 บาทต่อคน ค่าทำ Survey ควรจะ 250 บาทต่อคน

    Cost Per Interview คือ ต้นทุนต่อการสัมภาษณ์หนึ่งครั้ง


    Method

    • แบ่งประเทศเป็น 5 ภาคดังนี้
    SectorPercentage
    Northern Region10%
    Northeastern Region35%
    Southern Region15%
    Central Region30%
    Bangkok and Metropolitan Area10%
    1. แล้วกลับไปเสนอลูกค้า 1000 คนไปเสนอตามสัดส่วนในที่แบ่งตามเขตไว้
    2. เก็บข้อมูลจากจังหวัดที่ลูกค้าเยอะๆ เช่น ภาคอีสาน เก็บข้อมูลจากจังหวัดขอนแก่น จังหวัดบุรีรัมย์ จังหวัดโคราช, ภาคเหนือ จังหวัดเชียงใหม่
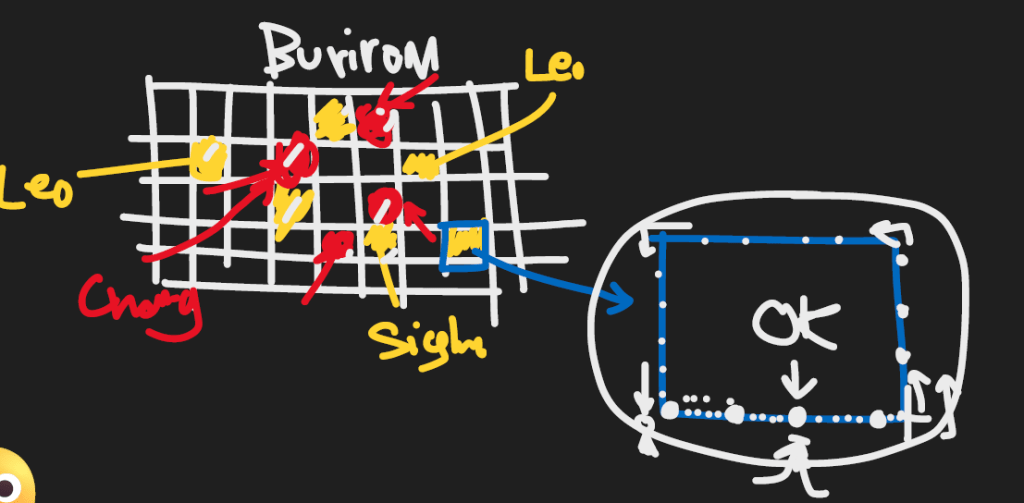
    3. แล้วจะมีแผนที่ของแต่ละจังหวัดเป็นตาราง Grid ของจังหวัดบุรีรัมย์
    Case Grid

    4. ใช้โปรแกรม Computer สุ่มเลยว่าอยากไปเดินสุ่มที่ Block ไหนของตาราง Computer


    The reality of customer interactions

    • แต่เมื่อเอา plan ไปเสนอลูกค้าที่เป็นการสุ่มเลือกพื้นที่สีเหลือง ลูกค้าเลือกพื้นที่สีแดงเลย

    ที่โปรแกรม Computer ในการสุ่มเลือกพื้นที่ต่างๆ ต้องการลดการ bias ในการเลือกพื้นที่

    1. ลูกค้าอยากเลือกพื้นที่เองเพราะลูกค้า Brand Chang อยากเลือกพื้นที่ที่หนีพื้นที่สีเหลืองที่คู่แข่งเก่งเช่น Leo กับ Singha
    2. โดยทีม Research จะต้องพยายามเลือกทั้งจังหวัดที่ Brand Chang เก่งและจังหวัดที่เราไม่เก่งด้วย เพื่อสร้างสมดุลในการเลือก Sample Size
    3. เวลาที่เก็บข้อมูลจริง จะใช้หลักการ Left hand Rule เวลาสัมภาษณ์หลังที่ 1 แล้วก็กระโดดสัมภาษณ์ 4 หลังแล้วสัมภาษณ์ต่อดังรูปสีฟ้า

    Case Population Census

    เริ่มจากไป Search ในสำนักงานสถิติแห่งชาติ

    รัฐบาลจะทำ Survey ว่า

    1. คนไทยมีจำนวนกี่คน
    2. ผู้ชายกี่คน ผู้หญิงกี่คน
    3. คนไทยทำอาชีพอะไร
    4. คนไทยมีความสุขในการใช้ชีวิตมั้ย
    • 10 ปีจะทำ Survey ครั้งนึงโดยการทำถาม Survey ตามบ้าน โดยมีการทำสำมะโนประชากรครั้งล่าสุดปี 2553
    Case Population Census

    สิ่งที่น่าเศร้าคือหน่วยงานรัฐบาลไม่ทำแล้วให้หน่วยงานเอกชนเป็นคนทำแทน Survey 2568


    Non Probability Sampling

    Convenience Sampling

    • เป็นวิธีการสุ่มตัวอย่างที่ไม่ต้องอาศัยหลักการทางสถิติที่ซับซ้อน แต่เน้นความง่ายและความสะดวกในการเข้าถึงกลุ่มตัวอย่าง

    เช่น สร้าง Suvery เป็นแบบสอบถามให้คนกรอก google form


    Case Google Form

    Case Google Form
    • เป็น Case ที่เด็กปริญญาโทมักจะต้องเก็บข้อมูลเพื่อทำวิจัย Project ต่างๆ

    Method

    1. เก็บ Sample Size 400 คน เป็นคนกรุงเทพ
    2. อายุ 20-35 ที่ชอบซื้อออนไลน์
    3. ส่วนใหญ่มักมีการเก็บข้อมูลผ่านการส่งให้เก็บข้อมูลทาง line และ facebook

    ข้อควรระวัง : แต่ถ้าให้เก็บข้อมูลผ่านเพื่อนๆ เช่น เด็ก ผู้หญิง จบโรงเรียนหญิง คนทำแบบทดสอบที่มักจะมาจากผู้หญิง


    TypeMen PercentageWomen Percentage
    Population50%50%
    Sampling20%80%

    หากจะเลือก Sample Size สุ่มให้ดี ควรเลือกกลุ่มที่มีความใกล้เคียง Population เช่นเลือกคนที่เป็นคนตอบแบบสอบถามให้ใกล้เคียง Population เช่น Sampling ควรมีผู้หญิง และผู้ชายเท่ากับ Population

    Sampling ที่สุ่มมาได้ผู้ชาย 20% ซึ่งไม่ตรงกับ Population ซึ่งทำให้ใช้จริงได้ยาก


    Cautions

    1. ทำให้ Sample ไม่สามารถ Represent กับ Population ที่เกิดขึ้นจริงได้
    2. สาเหตุมาจากวิธีการสุ่มตัวอย่างที่เรียก Convenience Sampling เพราะสุ่มตามที่เราสะดวก

    Snowball Sampling

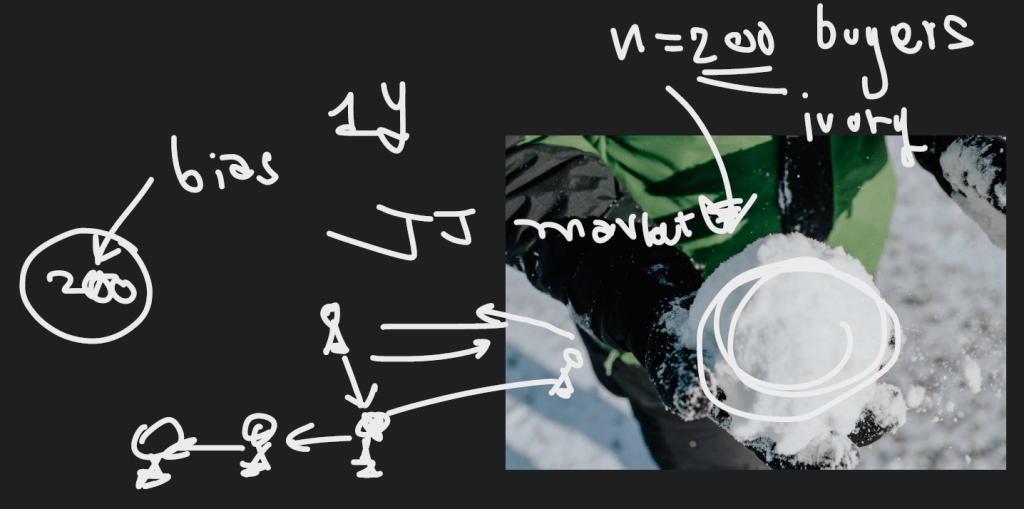
    การหากลุ่มตัวอย่างเริ่มต้นจำนวนเล็กน้อย จากนั้นให้กลุ่มตัวอย่างเหล่านั้นแนะนำสมาชิกคนอื่นๆ ในกลุ่มเป้าหมายเดียวกัน


    Case Ivory

    Case Ivory

    WWF เป็นองค์กรที่ปกป้องสัตว์ใกล้สูญพันธุ์


    ทำไมคนไทยถึงซื้องาช้าง?

    1. เพราะซื้อมาประดับบารมี
    2. ซื้อเพื่อโชว์ฐานะทางบ้าน
    3. ซื้อเพื่อความเชื่อบางอย่างและหน้าที่การเงิน

    เนื่องจากไม่รู้ว่าจะเก็บข้อมูลจากลูกค้ามาจากไหน เนื่องจากปกติไม่ค่อยมีกลุ่มลูกค้าที่ซื้องาช้าง

    Case Snowball Sampling

    Method

    1. ให้หาลูกค้า คนแรกที่ซื้องาช้าง ให้ได้ก่อน แล้วค่อยถามต่อไปเรื่อยๆ เป็น process
    2. แล้วทำ Survey ในประเทศไทย 200 คน
    3. ไปเก็บข้อมูล JJ market (Chatuchak) ที่ร้านขายงาช้าง แล้วสัมภาษณ์คนซื้องาช้างใน 1 ปีแล้วถาม ณ เวลานั้นเลย แล้วขอ Contact คนซื้องาช้างจากลูกค้าต่ออีกที เหมือนกับการโยนหิมะใส่กันไปเรื่อยๆจึงเรียก Snowball

    ได้กลุ่มตัวอย่างมา 200 คน แต่กลุ่มคน 200 คนนี้ความเห็นจะคล้ายๆกัน เพราะเป็นเพื่อนกันเลยขาดความหลากหลายของข้อมูล


    Data Collection

    1. เก็บ data ที่มีคุณภาพมาก่อนก็จะช่วยให้ได้การวิเคราะห์ข้อมูลที่มี make sense และถูกต้องมากยิ่งขึ้น
    2. คำถามแรกที่มักถูกถามคือ ข้อมูลมาจากไหน project data ที่เรามาจากไหน
    3. ถ้าลูกค้าไม่เชื่อกระบวนการเก็บ data ของเรา โอกาสที่ขายงานผ่านจะน้อยมาก
    4. ถ้าไม่เข้าใจวิธีการเก็บ data ที่ดีอาจจะทำให้การวิเคราะห์ data แบบ Regression ตั้งแต่แรกผิดไปเลยก็ได้
    5. ถ้า Sample ไม่ Represent Population ก็อาจจะไม่ต้องทำต่อเลยก็ได้

    Sample Size

    Sample Size

    Method

    1. สุ่มแบบที่ 3 n=300 คนจะได้ผลลัพธ์ที่ดีในการสุ่มแบบ Random Sampling
    2. ยิ่ง Sample Size เยอะ จะยิ่งได้ผลลัพธ์ดีขึ้นเท่านั้น
    3. n จำนวนเยอะ Quality ก็เยอะ ยิ่งเข้าใกล้ population

    สามารถคำนวน Sample Size ได้จาก Website นี้

    VariableDefinitionCalculate
    Population sizeจำนวนทั้งหมดของกลุ่มคนที่คุณสนใจศึกษา1000
    Confidence levelความน่าจะเป็นที่ผลการสำรวจของคุณจะสะท้อนความเป็นจริงของประชากรทั้งหมด95%
    Margin of errorช่วงความคลาดเคลื่อนที่ยอมรับได้ของผลการสำรวจ5
    Calculate sample size

    Confidence level ถ้าทำ Survey นี้ซ้ำ 100 ครั้ง จะมี 95 ครั้งได้ผลลัพธ์เหมือนเดิม เป็นระดับความเชื่อมั่นจากการทำซ้ำ

    • ยิ่งทำซ้ำเยอะๆ ก็ยิ่งได้ผลลัพธ์ที่มั่นใจขึ้นเรื่อยๆ

    Margin of error ค่าความคลาดเคลื่อนจากคนที่สุ่ม 278 อาจจะมีคนเห็นด้วย 70% ไม่เห็น 30% แล้วความคลาดเคลื่อนที่ขึ้นจาก 70% ที่ว่ามีคลาดเคลื่อน +-5% = [65%,75%] ได้เป็น lower bound และ upper bound

    ยิ่งความคลาดเคลื่อนของข้อมูลน้อยลง ก็จะสามารถได้ข้อมูลที่แม่นยำขึ้น

    Margin of Error vs Sample Size

    Margin of Error vs Sample Size

    Diminish Return

    Diminish Return

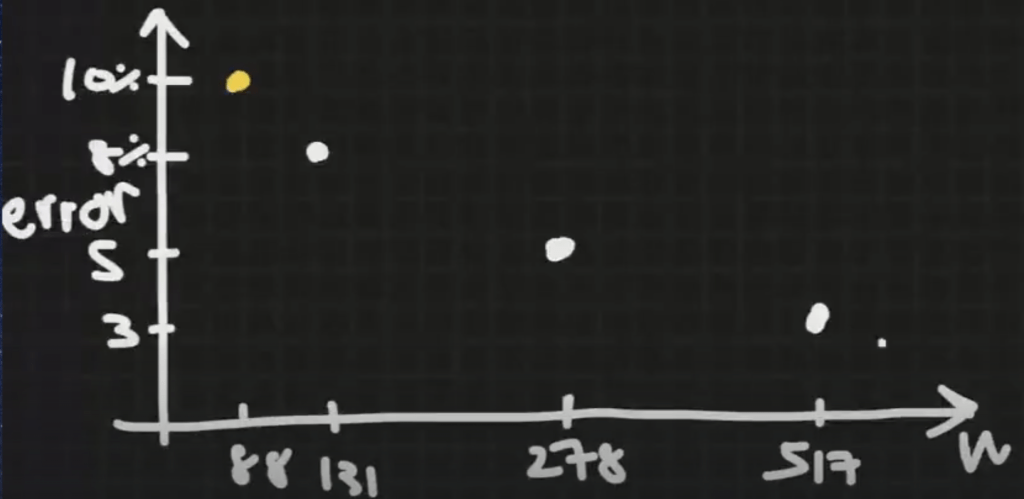
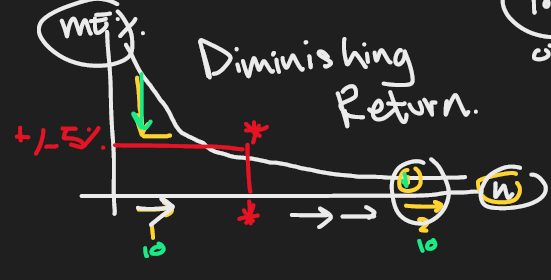
    Diminish Return สำหรับการเก็บข้อมูล ถ้ายิ่งเก็บ sample size เพิ่มทุกๆ 1 คน จะลด Error ในอัตราที่น้อยลงเรื่อยๆ

    เปรียบเสมือนกับ 1 ชั่วโมงแรกเราฝึกขี่จักรยานจะเก่งขึ้นก้าวกระโดดเพราะไม่เคยฝึก

    แต่ฝึกขี่จักรยานชั่วโมงที่ 2 จะเก่งขึ้นน้อยกว่าชั่วโมงแรก เพราะเรามีพื้นฐานขี่จักรยานเลยเก่งขึ้นน้อยลงกว่าตอนฝึกชั่วโมงแรก

    • นักสถิติคิดไว้แล้วว่าหยุดที่ Margin of Error 5% ที่เส้นสีแดงเพราะคุ้มค่าที่หยุดเก็บ Sample Size เพิ่มแล้ว

    ถ้าเราเก็บ n เยอะขึ้น ก้จะมีต้นทุนค่าใช้จ่ายเยอะขึ้น


    Margin of Error vs Sample Size vs Budget

    Margin of Error vs Sample Size vs Budget
    Margin of ErrorSample SizeBudget
    5%278278,000
    3%517517,000

    หากใช้ Margin of Error 5% – 3%=2% จะมีค่าใช้จ่ายเพิ่ม 517,000-278,000 = 239,000 บาท

    1. ในความจริงถ้าบอกลูกค้าว่าลด Error 2% มีค่าใช้จ่ายเพิ่ม 239,000 บาท แล้วแจ้งลูกค้าอาจจะไม่ยอมจ่าย เพราะราคาแพงเกินไป
    2. ความเป็นจริงลูกค้าเลือก Margin of Error 5%

    ค่า Margin of Error 5% ภาษาอังกฤษเรียก Arbitary ไม่ได้มีค่าตายตัว


    Confidence Level vs Sample Size

    Confidence Level vs Sample Size

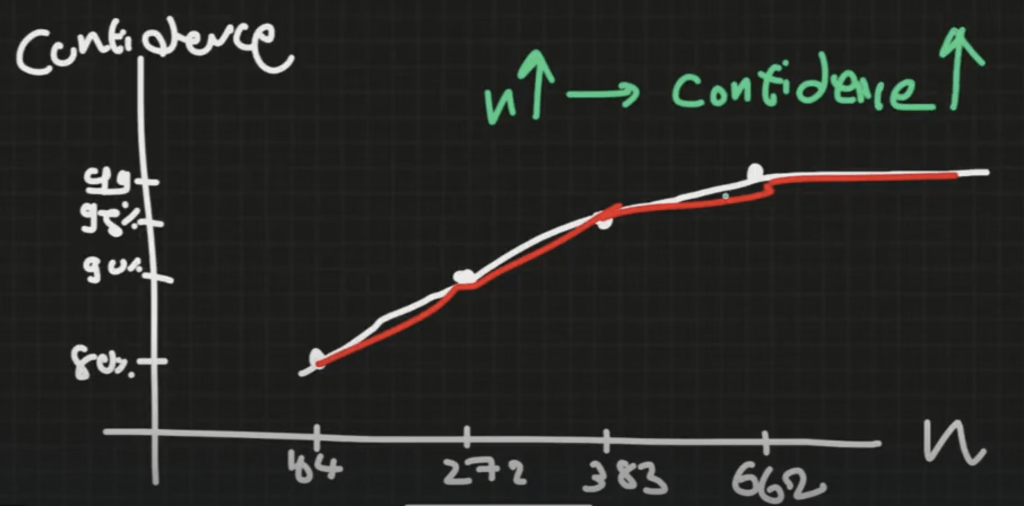
    Confidence Level แปรผันตรงกับ Sample Size

    Sample size = data

    1. ถ้าอยากตัดสินใจได้ดีขึ้นเรื่อยๆ ก็ควรจะเก็บ Data เยอะขึ้นเรื่อยๆ
    2. ถ้าอยากมี Career ที่ดีก็ต้องเรียนรู้ไปเรื่อยๆเลย อนาคตถึงจะสดใส

    ใครที่มีความรู้ที่อยู่ในหัวเยอะและเป็นข้อมูลที่มีคุณภาพก็จะเติบโตไปข้างหน้าได้ดีกว่าคนอื่น

    Recommend Statistic book : Naked Statistics


    Descriptive Stat

    1. ใช้ในการอธิบายค่าต่างๆ ที่สุ่มขึ้นมาจาก Sample
    2. เช่นใช้ค่า Mean, Median, Mode ในการวัดค่ากลางของ Sample Size

    Central tendency

    • การวัดค่ากลางของข้อมูล ควรเริ่มจากการเรียงข้อมูลเพื่อหาค่าเหล่านั้นได้ถูกต้อง
    Central Tendency

    Mean

    ค่าผลรวมของเลขทั้งหมด/จำนวนของเลขทั้งหมด

    ค่าเฉลี่ย = (5+10+10+15+22)/5 = 12.4


    Median

    ค่าตรงกลางของข้อมูล เช่น 5 10 10 15 22 ค่าที่อยู่ตรงกลางสุดคือ 10 เลข 10 จึงกลายเป็น Median


    Mode

    ค่าซ้ำมากสุดของข้อมูล เช่น 5 10 10 15 22 ค่าที่ซ้ำมากสุดคือ 10 จึงกลายเป็น Mode

    หากตัวเลขซ้ำกันมากกว่า 1 ตัวเช่น 5 10 10 15 15 ค่าที่ซ้ำมากสุดคือ 10, 15 จะเรียกว่า Bimodal

    Case Study supermarket

    เช่นคนจะเข้าไปซื้อของกินที่ Supermarket กันในช่วงเวลา กลางวันและเย็นเยอะ จึงกลายเป็นช่วงที่โดดเด่นจึงเรียกว่า Bimodal

    Multimodal AI can process virtually any input, including text, images, and audio เนื่องจากสามารถ create 3 อย่างพร้อมกันได้จึงกลายเป็น Multimodal


    Spread Tendency

    • วัดการกระจายตัวของข้อมูล
    TypeDefinition
    SD (variance)การกระจายตัวของข้อมูล
    Rangemax – min = ค่ามากสุด – ค่าน้อยสุด (พิสัย)
    Standard Deviation Formula

    Position

    TypeDefinition
    Minค่าต่ำสุดของข้อมูล
    Maxค่าสูงสุดของข้อมูล
    Percentileค่าของข้อมูล ณ จุด 99 จุด ที่แบ่งข้อมูลซึ่งเรียงจากน้อยไปหามากออกเป็น 100 ส่วน โดยที่แต่ละส่วนมีจำนวนข้อมูลเท่า ๆ กัน

    ถ้าคุณสอบได้คะแนนอยู่ในเปอร์เซ็นไทล์ที่ 80 หมายความว่าคุณได้คะแนนสูงกว่า 80% ของผู้สอบคนอื่นๆ ทั้งหมด


    Process of Distribution

    process ที่นักสถิติมี 2 วิธี ใช้ตัวเลขและกราฟในการวิเคราะห์ข้อมูล

    1. Numerical ตัวเลข
    2. Graphical กราฟ
    Histogram Graph
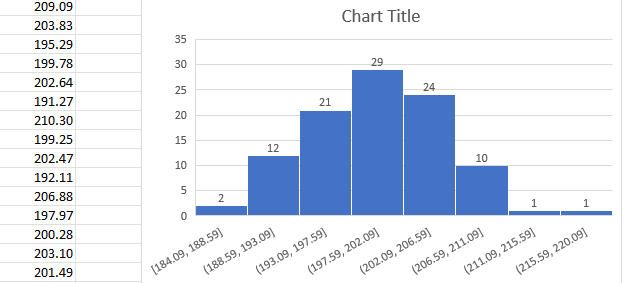
    • หลังสุ่มตัวเลขมา 100 เลขแล้วสามารถสร้าง Histogram ได้ดังรูปครับ
    จะสามารถได้ผลลัพธ์ที่มีการแจกแจง 3 แบบดังนี้

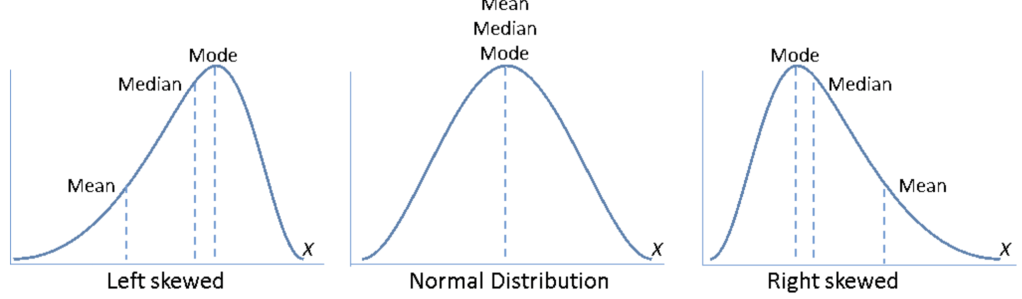
    TypeGraphRelationSample
    Normal Distributionกราฟรูประฆังคว่ำ สมมาตรMean = Median = Modeคะแนนสอบที่มีการ
    กระจายตัวดี
    Skewed Left Distributionหางยาวไปทางซ้ายMean < Median < Modeคะแนนสอบที่นักเรียนส่วนใหญ่ได้คะแนนสูง
    Skewed Right DistributionหางยาวไปทางขวาMean > Median > Modeคะแนนสอบที่นักเรียนส่วนใหญ่ได้คะแนนต่ำ
    3 Distribution

    Technique หางของกราฟไปทางฝั่งไหน ให้เบ้ไปทางฝั่งนั้น

    • ถ้าข้อมูลมีการเบ้ เรามักจะใช้ค่า Median ในการวัดค่ากลาง

    Normal Distribution

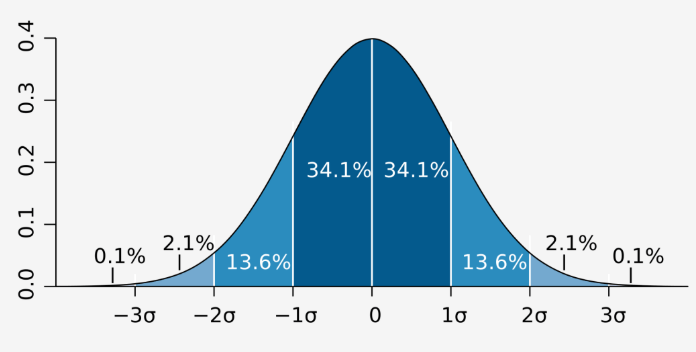
    1. (Bell Shape Curve) การกระจายตัวปกติ
    2. โดยพื้นที่ใต้กราฟมีค่าเป็น 1
    Normal Distribution
    Area under the graphPercentage
    1 SD68.2%
    2 SD95%
    3 SD99.7%

    Skewed Left Distribution

    • อย่างเช่นมีการสอบแล้วนักเรียนลืมไปสอบ 5 คนทำให้คะแนนสอบลดลงไปเยอะ
    • หากมีนักเรียนไม่ได้สอบ 5 คนจะทำให้ค่า Mean ตกจาก 66 คะแนน เป็น 52 คะแนน
    Skewed Left Distribution

    Skewed Right Distribution

    คนรวยมีจำนวนน้อย คนจนมีจำนวนมาก จะเบ้ขวา

    สามารถเช็ค Thailand GDP per Capita ได้ที่ link

    • GDP = เอารายได้คนทั้งประเทศ / จำนวนคนทั้งหมด = mean

    Prepare Two Graph

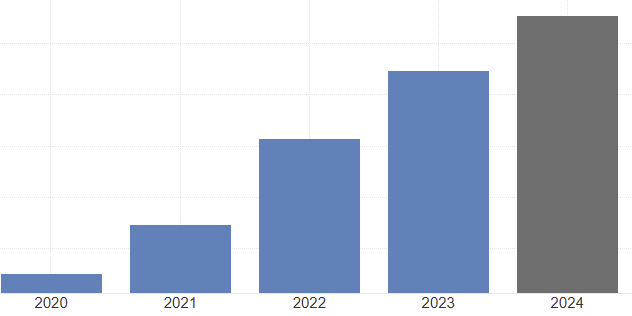
    2020-2024 GDP
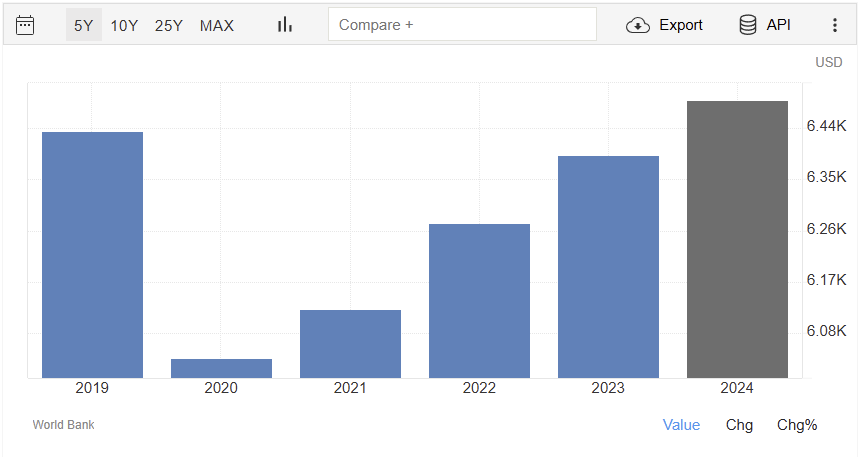
    2019-2024 GDP

    ถ้าดูแค่กราฟแรก รายได้เพิ่มมา 500 เหรียญในรอบ 5 ปี เพราะคนรวยในประเทศรายได้เพิ่ม

    หากนับปี 2019 ก่อนเกิดโควิดจะเห็นได้ว่ารายได้ในประเทศในรอบ 5 ปี ไม่เพิ่มเลย เราแค่มีรายได้กลับมาใกล้กับปีที่มี 2019


    Outlier

    Outlier

    Method

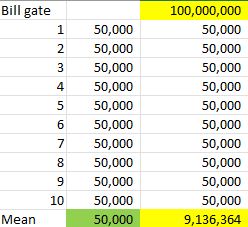
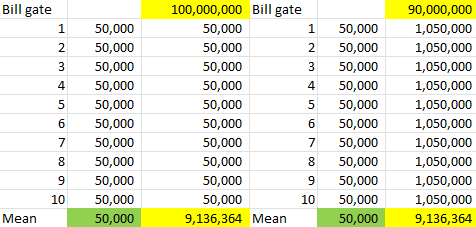
    1. ตอนแรกค่าเฉลี่ยคนในประเทศอยู่ 50,000 บาท 10 คน แต่มี Bill gate เพิ่มเข้ามาจะทำให้ค่าเฉลี่ยเพิ่มขึ้นจาก 50,000 บาท เป็น 9,136,634 บาท
    2. การเพิ่มเข้ามาของ Bill Gate เรียกว่า Outlier
    3. จึงเป็นสาเหตุให้รายได้ของประเทศมีการกระจายตัวเบ้ขวาเพราะคนรวยเพิ่มมาบางคนทำให้ค่าเฉลี่ยนในประเทศเปลี่ยนไปมาก

    Case Singapore GDP

    ที่ Singapore GDP สูงแต่คนในประเทศลำบากเช่นค่าน้ำ 60 บาท

    GDP per capital ไม่สื่อถึงการกระจายรายได้ แต่ยังใช้ค่าเฉลี่ยอยู่เพราะยังหาวิธีที่ดีกว่าไม่ได้

    GDP เท่าเดิม แต่คนในประเทศ 90% สามารถมีความสุขได้โดยการที่คนรายได้สูง 10% ของประเทศ ยอมจนลง 10% กระจายรายได้ของคนในประเทศนี้จะดีขึ้นได้ตามรูปด้านล่าง

    หาก bill gate แบ่งเงินรายได้ 10% คนในประเทศรายได้ขึ้นหลายเท่าได้เลย

    หาก Bill Gate แบ่งเงินรายได้ 10% คนในประเทศรายได้เพิ่มขึ้นหลายเท่าได้เลย


    หวังว่าการบทความสรุปเกี่ยวกับสถิติและเคสตัวอย่างที่ยกตัวอย่างไป จะสามารถนำไปประยุกต์ใช้ในชีวิตประจำวันแล้วทำให้ตัดสินใจดีขึ้นโดยอ้างอิงสถิติทางทฤษฎีไปสู่ชีวิตจริงครับ

    ขอบคุณคอร์ส Essential Statistic 1 จาก Data Science Bootcamp 11 DataRockie : https://data-science-bootcamp1.teachable.com/courses/enrolled/2684443